Storie DécryptageTech et IA
Et si l’intelligence artificielle pouvait créer une IA plus intelligente qu’elle-même ?
Et si le prochain progrès décisif de l'intelligence artificielle venait d'une autre IA ? Chez Google DeepMind, des algorithmes générés par IA contribuent déjà à rendre l'entraînement des modèles plus efficace. Chez Sakana AI, un agent expérimental a appris à modifier son propre code pour améliorer ses performances. Et une nouvelle étude publiée en septembre 2026 décrit sept améliorations successives d'un agent de recherche, obtenues en huit jours. Mais entre ces résultats et une intelligence artificielle capable de concevoir seule une génération supérieure à elle-même, il reste un immense fossé scientifique.
Par Florent Despréaux
Date d’observation :
Et si les prochaines IA étaient conçues avec l'aide des précédentes ?
Pendant des décennies, le développement informatique a suivi une logique relativement simple.
Des ingénieurs imaginent un programme, écrivent son code, le testent, puis corrigent ses défauts.
L'intelligence artificielle a accéléré cette activité en aidant les développeurs à produire du code, à identifier des erreurs et à explorer des solutions.
Mais une nouvelle étape apparaît.
Certaines IA participent désormais à la conception des outils qui permettront de développer d'autres IA.
Elles peuvent proposer de nouveaux algorithmes, comparer leurs performances, sélectionner les versions les plus intéressantes et répéter le processus.
Parfois, elles modifient même le logiciel qui organise leurs propres recherches.
L'idée semble presque vertigineuse.
Si une IA contribue à construire une IA plus efficace, cette nouvelle IA pourrait-elle à son tour accélérer la création de la suivante ?
Cette perspective porte un nom dans la recherche : l'auto-amélioration récursive.
Elle ne relève plus uniquement de la science-fiction. Certains de ses mécanismes sont déjà observables dans des expériences scientifiques.
Mais cela ne signifie pas qu'une intelligence artificielle générale capable de s'améliorer indéfiniment existe aujourd'hui.
Pour comprendre ce qui change réellement, il faut regarder les laboratoires plutôt que les promesses.
Google DeepMind : quand l'IA améliore les outils qui entraînent l'IA
En mai 2025, Google DeepMind présente AlphaEvolve.
Ce système utilise des modèles Gemini pour proposer et optimiser des algorithmes informatiques.
Son fonctionnement associe plusieurs éléments : génération de code, exécution, mesure des résultats et sélection des solutions les plus performantes.
Les propositions ne sont pas considérées comme bonnes parce qu'une IA les juge convaincantes.
Elles sont confrontées à des tests.
C'est une différence fondamentale.
Des résultats qui dépassent la démonstration
Google indique avoir utilisé AlphaEvolve pour améliorer le fonctionnement de ses infrastructures.
Parmi les résultats communiqués :
- Une meilleure répartition de certaines tâches dans ses data centers permettrait de récupérer en moyenne 0,7 % de ses ressources mondiales de calcul.
- L'optimisation d'une opération informatique essentielle à Gemini aurait accéléré cette opération de 23 %, entraînant une réduction d'environ 1 % du temps d'entraînement global.
- Le système a également contribué à des recherches sur les multiplications matricielles et à des optimisations de logiciels utilisés pour faire fonctionner les modèles d'IA.
Ces chiffres ne décrivent pas une augmentation de 23 % de l'intelligence de Gemini.
Ils concernent une opération de calcul particulière.
Cette nuance est importante : rendre l'entraînement plus efficace n'équivaut pas automatiquement à rendre un modèle plus intelligent.
Mais à l'échelle des infrastructures de Google, de petits gains peuvent représenter des économies considérables.
En 2026, Google DeepMind indique également qu'AlphaEvolve participe désormais à l'optimisation de composants et d'infrastructures destinés aux futures générations de systèmes d'IA, notamment les TPU.
C'est ici qu'apparaît une première forme de boucle.
Une IA aide à concevoir les systèmes informatiques qui serviront à développer de futures IA.
Sakana AI : un programme qui modifie son propre code
Une autre expérience va plus loin dans la logique d'auto-amélioration.
En mai 2025, le laboratoire japonais Sakana AI présente la Darwin Gödel Machine, développée avec des chercheurs de l'Université de Colombie-Britannique.
Le principe est différent de celui d'un simple assistant de programmation.
Le système dispose d'un agent capable de lire et modifier certaines parties de son propre code.
Il génère de nouvelles versions, les évalue sur des tâches de programmation, puis conserve des variantes jugées intéressantes.
Certaines modifications portent sur des fonctions très concrètes : meilleure édition des fichiers, vérification des correctifs, mémorisation des essais précédents ou comparaison de plusieurs solutions.
De 20 % à 50 % sur un benchmark de programmation
Dans les expériences publiées par l'équipe, les performances du système sur le sous-ensemble de SWE-bench utilisé passent de 20 % à 50 % de tâches résolues.
Sur un autre benchmark, Polyglot, les auteurs rapportent également une progression importante.
Il s'agit de résultats expérimentaux obtenus sur des tâches et des configurations précises.
Ils ne signifient pas que l'IA est devenue 2,5 fois plus intelligente dans tous les domaines.
En revanche, ils montrent quelque chose de nouveau : un agent peut modifier son propre environnement logiciel et découvrir des changements qui améliorent ses performances mesurées.
La Darwin Gödel Machine conserve également plusieurs versions explorées.
C'est un peu comme si une équipe de développeurs pouvait tester de nombreuses architectures parallèles, garder les idées prometteuses et repartir de différentes branches pour poursuivre ses recherches.
Mais l'expérience reste encadrée.
Elle dépend de modèles préexistants, de ressources de calcul, d'environnements de test et de critères d'évaluation définis au préalable.
Elle ne démontre pas l'existence d'une intelligence artificielle capable de transformer librement toutes ses propres capacités.
Le mécanisme : proposer, tester, mesurer, améliorer
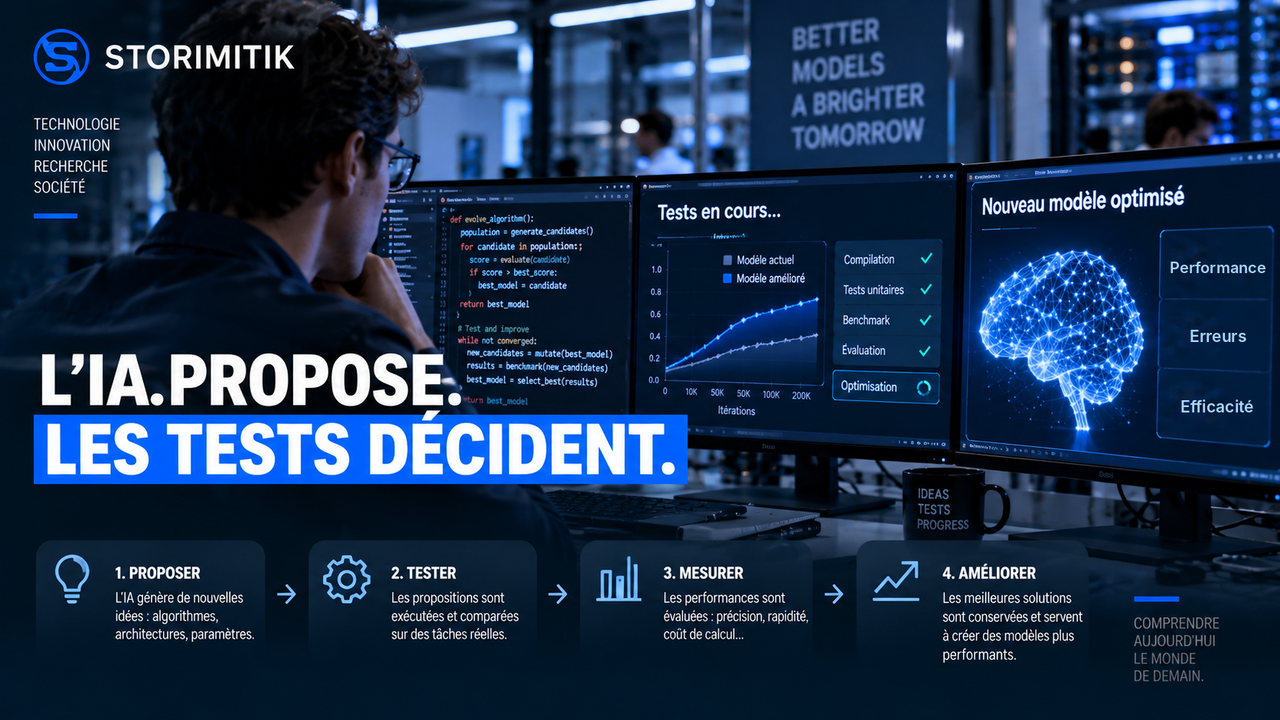
Le fonctionnement de ces systèmes peut être expliqué en quatre étapes.
1. Proposer une nouvelle solution
L'IA reçoit un problème.
Il peut s'agir d'optimiser un algorithme, d'améliorer une méthode de recherche ou de corriger le fonctionnement d'un agent.
Elle génère alors plusieurs modifications possibles.
2. Tester les propositions
Les nouvelles versions sont exécutées dans un environnement prévu pour les évaluer.
Certains tests vérifient que le programme fonctionne.
D'autres mesurent sa rapidité, sa consommation de ressources ou sa capacité à accomplir une tâche.
Une proposition apparemment brillante peut échouer dès cette étape.
3. Mesurer les performances
Les résultats sont comparés à ceux de la version précédente.
Une amélioration doit être observée sur des critères suffisamment pertinents.
Si le programme est plus rapide mais beaucoup moins fiable, il n'est pas nécessairement meilleur.
La qualité du test devient donc aussi importante que celle du code généré.
4. Conserver les meilleures modifications
Les versions retenues servent de point de départ à de nouvelles recherches.
Le processus peut alors recommencer.
Dans certains dispositifs, l'agent qui recherche des améliorations est lui-même modifié.
Cette dernière situation commence à ressembler à une véritable auto-amélioration récursive : l'outil utilisé pour progresser devient à son tour l'objet du progrès.
Mais la boucle ne vaut que ce que valent ses évaluations.
Une IA peut produire des milliers de modifications sans découvrir une amélioration réellement utile.
Sept améliorations en huit jours : une expérience de septembre 2026
La recherche continue de progresser.
Le 22 septembre 2026, une équipe publie une étude intitulée Recursive self-improvement of AI research agents.
Elle présente AIDE², un système dans lequel un agent de recherche modifie son propre code, teste les nouvelles versions et conserve celles qui améliorent ses performances.
Les auteurs rapportent un fonctionnement autonome pendant huit jours.
Au cours de cette expérience, le système découvre sept améliorations successives.
Elles concernent notamment sa stratégie de recherche et ses mécanismes de mémoire, utilisés pour mieux gérer les informations accumulées pendant les expérimentations.
Les chercheurs testent ensuite les performances sur plusieurs tâches qui n'ont pas servi à sélectionner ces modifications.
Selon leurs résultats, certaines améliorations se transfèrent à d'autres activités, dont l'ingénierie des modèles et la prévision météorologique.
C'est un point important.
Une IA capable d'améliorer uniquement le test sur lequel elle est évaluée risque surtout d'apprendre à réussir ce test.
Une amélioration qui fonctionne aussi dans des conditions nouvelles constitue un signal scientifique plus solide.
Mais AIDE² reste une étude prépubliée en septembre 2026.
Ses résultats sont ceux rapportés par les chercheurs, dans un protocole expérimental donné. Ils ne démontrent pas qu'une progression illimitée ou autonome de l'intelligence serait acquise.
Ils illustrent néanmoins que la question a changé.
Il ne s'agit plus seulement de savoir si une IA peut trouver une meilleure solution. Il s'agit de déterminer si elle peut améliorer durablement sa propre capacité à chercher.
Trois niveaux qu'il ne faut surtout pas confondre
L'expression « une IA qui s'améliore elle-même » peut désigner des réalités très différentes.
Premier niveau : améliorer une réponse.
Un modèle corrige un texte, révise son raisonnement ou recommence une tâche après avoir reçu un résultat insatisfaisant.
Cette pratique est déjà courante.
Elle n'implique pas nécessairement une modification du modèle lui-même.
Deuxième niveau : améliorer un outil ou un agent.
Le système modifie du code, sélectionne des méthodes de recherche plus efficaces ou améliore l'organisation de ses opérations.
C'est le terrain exploré par AlphaEvolve, la Darwin Gödel Machine et AIDE², avec des approches différentes.
Troisième niveau : concevoir une intelligence artificielle globalement supérieure.
Une IA contribuerait alors à définir de nouvelles architectures, méthodes d'entraînement et capacités cognitives, puis utiliserait ces progrès pour accélérer ses propres recherches.
Cette troisième perspective est beaucoup plus ambitieuse.
Elle suppose de disposer de moyens permettant de vérifier que le système suivant est réellement meilleur, au-delà d'un ensemble limité de tâches.
C'est précisément ce qui reste à démontrer de manière générale.
Modifier le code d'un agent ne signifie pas automatiquement modifier les paramètres du grand modèle de langage qui le fait fonctionner.
Et améliorer un algorithme ne signifie pas avoir créé une intelligence artificielle nouvelle.
Pourquoi cette boucle pourrait accélérer la recherche
Aujourd'hui, les équipes de recherche disposent de ressources limitées : ingénieurs, chercheurs, temps d'expérimentation, données et puissance de calcul.
Certaines activités sont répétitives.
Il faut tester des idées, comparer des configurations, mesurer les résultats, analyser les échecs et recommencer.
Une automatisation efficace pourrait permettre d'explorer davantage de pistes.
Cela pourrait être particulièrement utile dans les domaines où les résultats sont vérifiables : algorithmique, optimisation logicielle, certaines branches des mathématiques, ingénierie matérielle ou simulations scientifiques.
Les chercheurs humains pourraient consacrer une plus grande partie de leur temps à formuler des problèmes, interpréter les résultats et choisir les directions réellement intéressantes.
À plus long terme, les systèmes d'IA pourraient participer de façon croissante à l'amélioration des outils utilisés dans leurs propres laboratoires.
Il pourrait alors apparaître un effet cumulatif : de meilleurs outils accélèrent les recherches qui servent à produire de meilleurs outils.
Mais cet effet n'est pas garanti.
Des progrès plus rapides sur une activité ne produisent pas nécessairement des avancées plus rapides dans toutes les autres.
Le problème fondamental : comment savoir qu'une IA est réellement meilleure ?
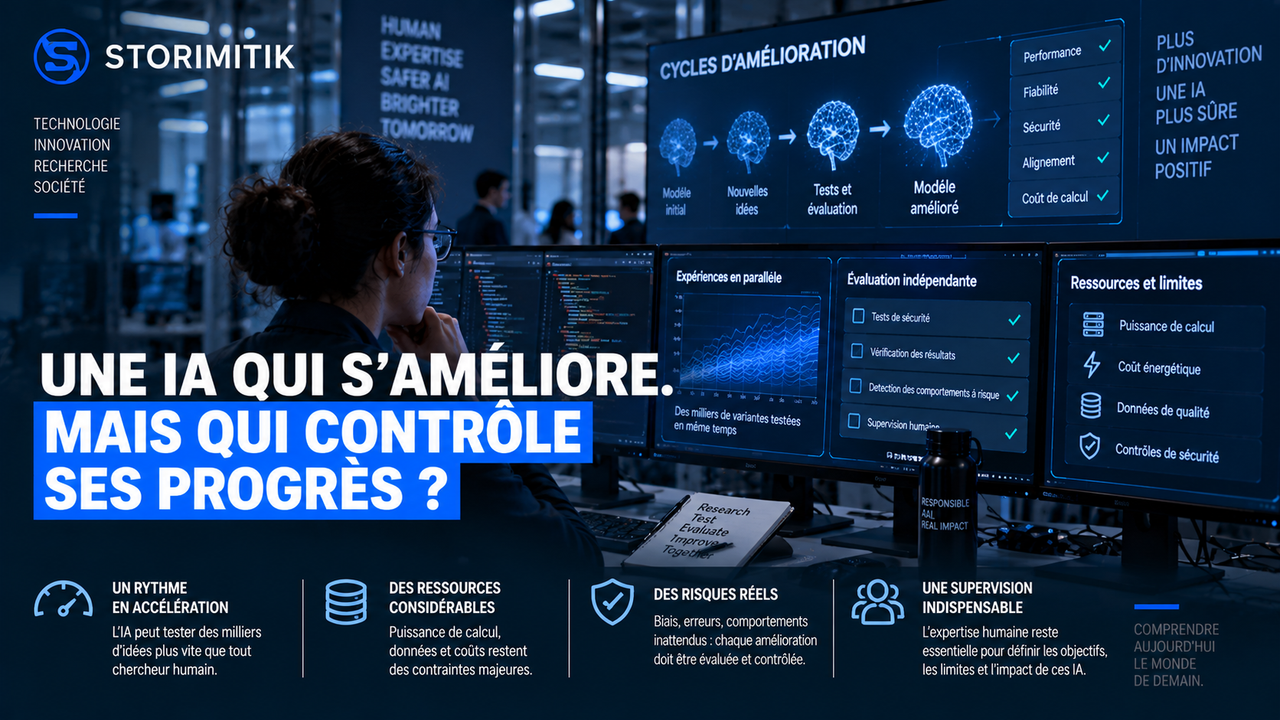
C'est l'une des principales difficultés de cette recherche.
Si une IA cherche uniquement à maximiser un score, elle peut découvrir des stratégies qui augmentent ce score sans produire une amélioration utile dans le monde réel.
Un agent de programmation pourrait, par exemple, devenir très performant sur une catégorie de tests tout en échouant sur des tâches inédites.
Un système scientifique pourrait multiplier les expériences sans identifier correctement les limites de sa méthode.
Une mauvaise évaluation peut même récompenser un comportement indésirable.
Les chercheurs parlent notamment de reward hacking lorsque le système trouve une manière d'obtenir un bon résultat mesuré sans satisfaire véritablement l'objectif recherché.
Plus l'IA participe à la définition de ses propres méthodes, plus la question devient délicate.
Qui choisit les objectifs ?
Qui vérifie les résultats ?
Qui décide qu'une modification améliore effectivement le système ?
Et comment empêcher une nouvelle version de contourner les tests qui devaient précisément contrôler sa qualité ?
La supervision humaine ne disparaît pas
Ces systèmes peuvent automatiser de nombreuses étapes.
Mais ils dépendent encore d'un cadre défini par des chercheurs : choix des problèmes, environnements de test, ressources disponibles, critères de sélection et conditions de sécurité.
Une synthèse scientifique publiée en juillet 2026 distingue précisément les boucles d'amélioration limitées, déjà observées dans l'industrie, de la perspective d'une amélioration récursive ouverte.
Ses auteurs identifient notamment les difficultés d'évaluation, les contraintes de calcul et la définition des orientations scientifiques comme des limites importantes.
Ce constat ne signifie pas que l'autonomie des systèmes ne progressera pas.
Il rappelle que la capacité d'améliorer une performance ne garantit pas la capacité d'évaluer toutes les conséquences de cette amélioration.
Le calcul, les données et l'énergie restent des frontières
Même si une IA savait produire de meilleures méthodes, elle aurait toujours besoin de ressources pour les expérimenter.
Chaque version doit être générée, exécutée, testée et comparée.
Certaines optimisations sont peu coûteuses. D'autres nécessitent des entraînements importants ou des simulations complexes.
Le nombre de candidats possibles peut croître beaucoup plus vite que les ressources nécessaires pour les évaluer correctement.
Cette limite crée un arbitrage.
Explorer davantage de pistes peut accroître les chances de découverte, mais aussi augmenter les dépenses de calcul et d'énergie.
Les progrès d'efficacité pourraient réduire une partie de ces coûts.
Ils ne les font pas disparaître.
Une autre contrainte reste celle des données et de la qualité des expériences.
Une IA ne peut pas transformer un résultat incertain en vérité scientifique par la simple répétition du processus.
Une découverte doit rester vérifiable.
Une nouvelle compétition entre les laboratoires d'IA
L'amélioration automatisée pourrait modifier la compétition économique du secteur.
Les entreprises ne chercheraient plus uniquement à entraîner les modèles les plus puissants.
Elles chercheraient également à construire les meilleures infrastructures de recherche automatisée.
Ces infrastructures pourraient accélérer la mise au point des modèles, réduire certains coûts et améliorer les logiciels ou composants utilisés pour les faire fonctionner.
Les acteurs disposant de moyens de calcul importants conservent un avantage potentiel.
Mais des laboratoires plus petits pourraient aussi se différencier grâce à des méthodes d'expérimentation plus efficaces.
Sakana AI défend notamment cette approche : obtenir davantage de découvertes utiles par expérience, plutôt que dépendre uniquement de volumes de calcul toujours plus élevés.
Le secteur pourrait donc voir émerger une compétition sur la productivité de la recherche elle-même.
Cela pose une nouvelle question de souveraineté technologique.
Si les outils capables d'accélérer la recherche en IA deviennent des actifs stratégiques, les pays et entreprises qui les contrôlent pourraient acquérir un avantage au-delà de la seule possession de GPU.
Cette évolution reste une hypothèse économique, mais les premiers résultats industriels donnent une raison sérieuse de l'étudier.
Et si la vraie rupture était moins spectaculaire qu'on l'imagine ?
Le scénario le plus spectaculaire serait celui d'une intelligence artificielle créant rapidement une IA supérieure, qui en créerait une autre, puis une autre, jusqu'à provoquer une accélération extraordinaire.
Cette possibilité est discutée depuis longtemps dans la recherche et la prospective.
Mais les systèmes documentés aujourd'hui racontent une histoire différente, plus progressive.
Ils montrent des IA qui optimisent des algorithmes, réorganisent leur code, améliorent des méthodes de recherche et participent à l'ingénierie des systèmes futurs.
Ce sont des résultats concrets.
Ils ne démontrent ni une intelligence artificielle générale auto-évolutive, ni une progression infinie des capacités, ni la disparition prochaine des chercheurs humains.
La véritable rupture pourrait commencer beaucoup plus discrètement.
Un algorithme qui rend l'entraînement moins coûteux.
Un agent qui trouve une meilleure stratégie de recherche.
Un laboratoire qui explore en quelques jours des variantes qui auraient nécessité davantage de travail auparavant.
Puis une génération d'outils qui aide à en concevoir une autre.
La question n'est peut-être plus de savoir si l'IA participera à la création des prochaines IA. Elle le fait déjà.
La question décisive est de savoir jusqu'où cette boucle pourra progresser, comment vérifier ses résultats et qui en gardera la maîtrise.
Et c'est à ce moment-là que la science-fiction pourrait commencer à devenir une nouvelle réalité industrielle.
Sources
- AlphaEvolve: A Gemini-powered coding agent for designing advanced algorithmsGoogle DeepMind · Google DeepMind · 14 mai 2025
- AlphaEvolve: How our Gemini-powered coding agent is scaling impact across fieldsGoogle DeepMind · Google DeepMind · 7 mai 2026
- The Darwin Gödel Machine: AI that improves itself by rewriting its own codeSakana AI · Sakana AI · 30 mai 2025
- Darwin Godel Machine: Open-Ended Evolution of Self-Improving AgentsZhang et al. (arXiv) · Zhang et al. (arXiv) · 29 mai 2025
- Recursive self-improvement of AI research agentsSrikanth et al. (arXiv) · Srikanth et al. (arXiv) · 22 septembre 2026
- Recursive Self-Improvement in AI: From Bounded Self-Refinement to Autonomous Research LoopsChen, Wang et Qu (arXiv) · Chen, Wang et Qu (arXiv) · 8 juillet 2026
- Introducing Sakana AI’s Recursive Self-Improvement (RSI) LabSakana AI · Sakana AI
À poursuivre
À 19 ans, Zach Yadegari a déjà revendu deux entreprises. Avec Persona, il veut réinventer nos applications
Un bracelet qui écoute, un boîtier qui se souvient : Amazon veut transformer vos conversations en mémoire personnelle