
Storie DécryptageTech et IA
10 décisions en 51 ms sur un H200 : OneJev ne veut plus faire parler l’IA, mais la faire décider
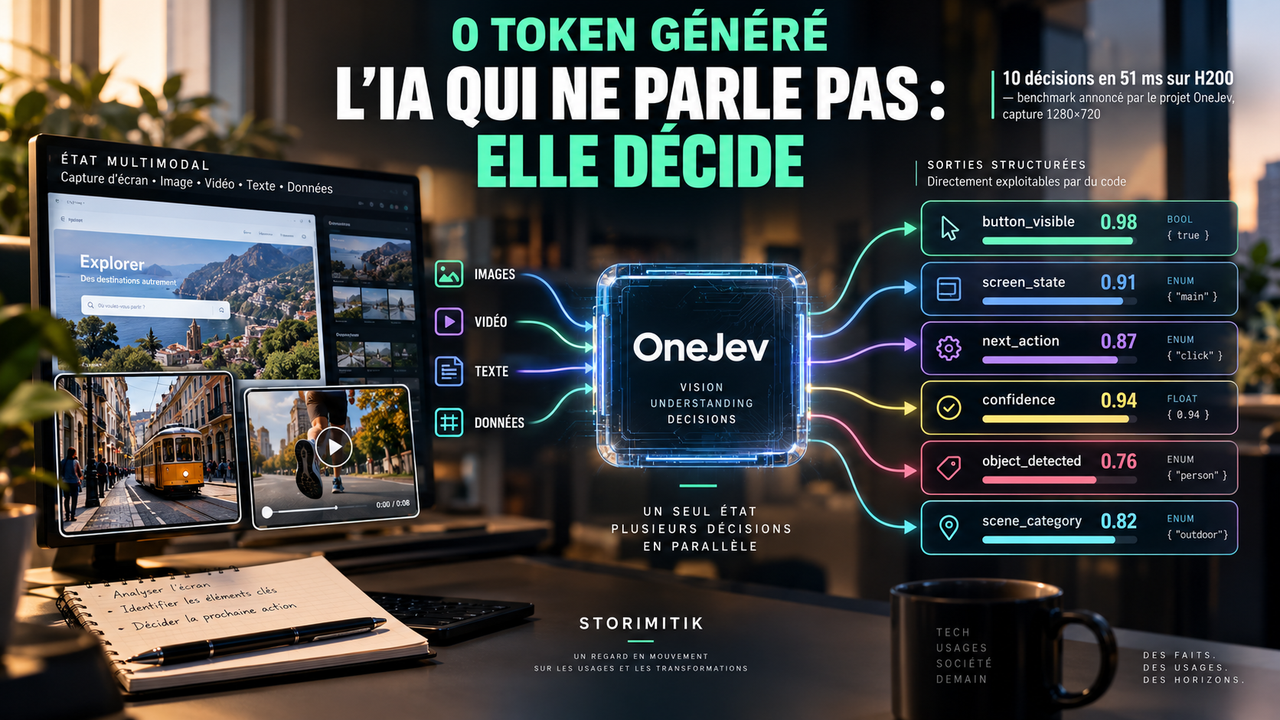
OneJev prend le contrepied du chatbot. À partir d’une capture, d’une image, d’une vidéo ou de texte, il répond à des questions prédéfinies par des probabilités directement exploitables par du code. Sur son propre benchmark, la version 0,8B annonce 10 décisions en 51 ms sur un H200. Une promesse séduisante pour l’automatisation — à condition de ne pas confondre sortie valide et décision juste.
Par Florent Despréaux
Et si l’IA n’avait plus besoin de rédiger une réponse ?
La plupart des modèles d’IA que nous utilisons aujourd’hui ont été conçus pour produire des chaînes de caractères : une phrase, un résumé, du code ou un bloc JSON. OneJev prend le problème dans l’autre sens. L’application définit à l’avance les questions et les réponses possibles ; le modèle renvoie directement une distribution de probabilités sur ces options.
Autrement dit, son ambition n’est pas de devenir un meilleur chatbot. Elle est de devenir un composant de décision que du logiciel peut appeler, mesurer et encadrer.
Un état, plusieurs décisions, un seul passage
OneJev accepte du texte, des captures d’écran, des photos et des séquences vidéo. Le même état multimodal peut ensuite alimenter plusieurs questions typées : un bouton est-il visible ? L’écran est-il dans un menu ou dans le jeu ? Quelle action choisir parmi cliquer, attendre, défiler ou arrêter ?
Selon le dépôt du projet, l’état est lu une seule fois puis chaque question devient une courte branche issue de cette représentation partagée. Le résultat n’est pas un paragraphe à relire : pour chaque question, OneJev renvoie les probabilités des options autorisées.
Pourquoi c’est différent d’un JSON bien formaté
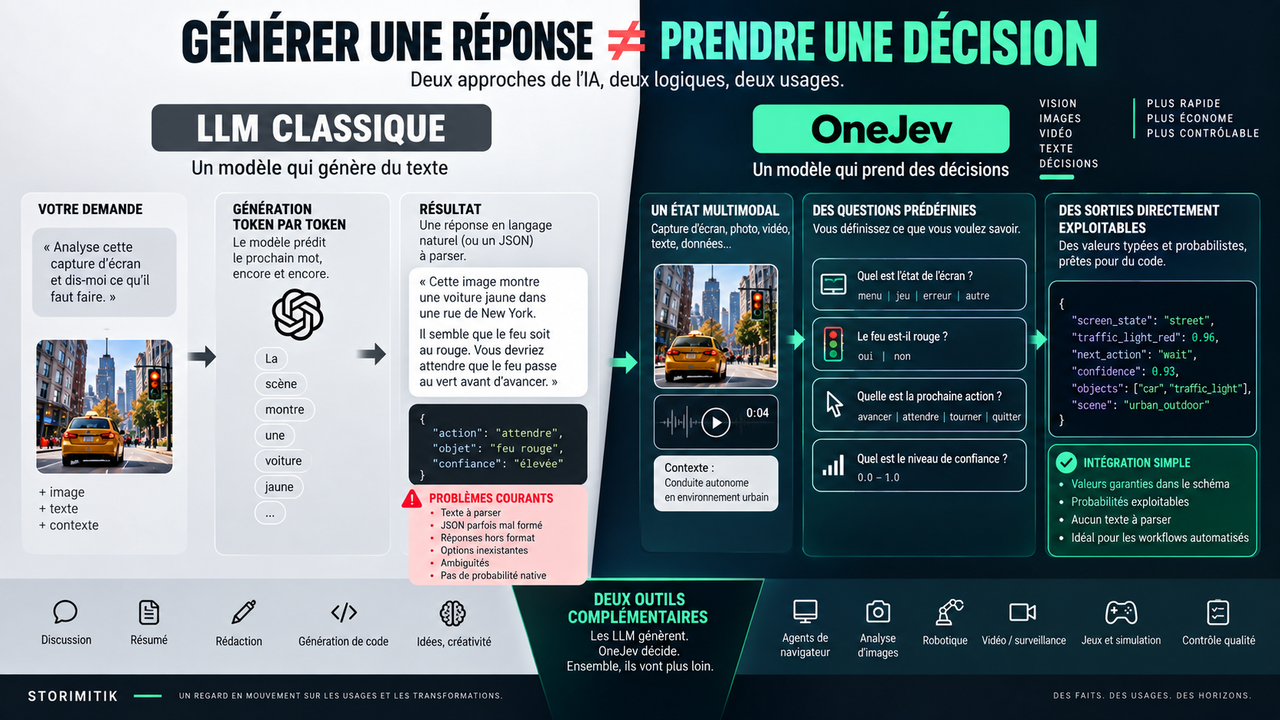
Un LLM peut déjà être contraint par un schéma JSON ou par des outils de structured output. Mais sa logique de base reste générative : il produit une séquence. OneJev est entraîné autour d’un espace de réponses borné et lit les probabilités des options directement à la sortie du modèle.
Cela change surtout la frontière entre le modèle et le code. Avec OneJev, l’application connaît les choix possibles avant l’inférence. Elle peut ensuite appliquer ses propres règles : agir au-dessus d’un seuil, demander une validation humaine dans une zone intermédiaire, ou s’abstenir.
31 ms pour une question, 51 ms pour dix — mais dans un benchmark très précis
Le chiffre le plus spectaculaire publié par OmniJev concerne OneJev-0.8B : sur un GPU Nvidia H200, avec une capture 1280 × 720, le projet mesure 31 ms pour une question et 51 ms pour dix questions dans la même requête.
Ce résultat illustre l’intérêt du partage du préfixe multimodal, mais il ne doit pas être transformé en promesse universelle. Il s’agit d’un benchmark des auteurs, sur un matériel haut de gamme et une configuration déterminée. La latence réelle dépendra du modèle choisi, de la résolution, de la vidéo, du runtime, de la quantification et du matériel.
Quatre tailles ouvertes, basées sur Qwen
OneJev est publié sous l’organisation OmniJev en quatre tailles principales : 0,8B, 4B, 9B et 27B. Les auteurs indiquent avoir réalisé un fine-tuning complet de Qwen3.5-0.8B, Qwen3.5-4B, Qwen3.5-9B et Qwen3.8-27B, avec la tour de vision gelée.
Les poids sont disponibles publiquement et le dépôt est placé sous licence Apache-2.0. Le projet indique que les quatre tailles ont été entraînées sur 99 193 questions provenant de runs d’agents, de vidéos et d’images.
OneJev n’est pas Jev
La proximité des noms peut prêter à confusion. Jev est le modèle System One lancé par TypeSafe AI. TypeSafe le présente comme un modèle propriétaire hébergé qui reçoit un état et renvoie des décisions typées accompagnées de probabilités.
OneJev, lui, est publié par OmniJev. Son serveur reprend le contrat de l’API System One de TypeSafe et l’étend avec un champ multimédia pour les images et la vidéo. C’est donc une implémentation ouverte de la même philosophie d’interface, avec sa propre architecture d’entraînement, ses propres poids et ses propres benchmarks.
Le vrai avantage : arrêter de parser des réponses qui n’auraient jamais dû être du texte
Dans un agent de navigateur ou une chaîne de surveillance, la question n’est souvent pas « explique-moi ce que tu vois », mais « le bouton est-il visible ? », « l’utilisateur a-t-il fini ? » ou « quelle action parmi ces quatre faut-il tenter ? ». Générer plusieurs phrases pour revenir ensuite à un booléen ou à une étiquette ajoute de la latence et de la fragilité.
OneJev cherche précisément à éliminer cette étape. Les primitives Choice, Noul et Score permettent respectivement de choisir parmi des options, d’estimer la probabilité d’une proposition vraie, ou de positionner un état sur une échelle ordonnée.
Mais une sortie valide peut être parfaitement fausse
C’est la limite la plus importante. Garantir qu’une réponse appartient au schéma autorisé n’est pas garantir que le modèle a correctement compris l’image. Une mauvaise perception, une classe absente des options, un contexte inhabituel ou une mauvaise calibration peuvent conduire à une décision incorrecte qui reste techniquement irréprochable.
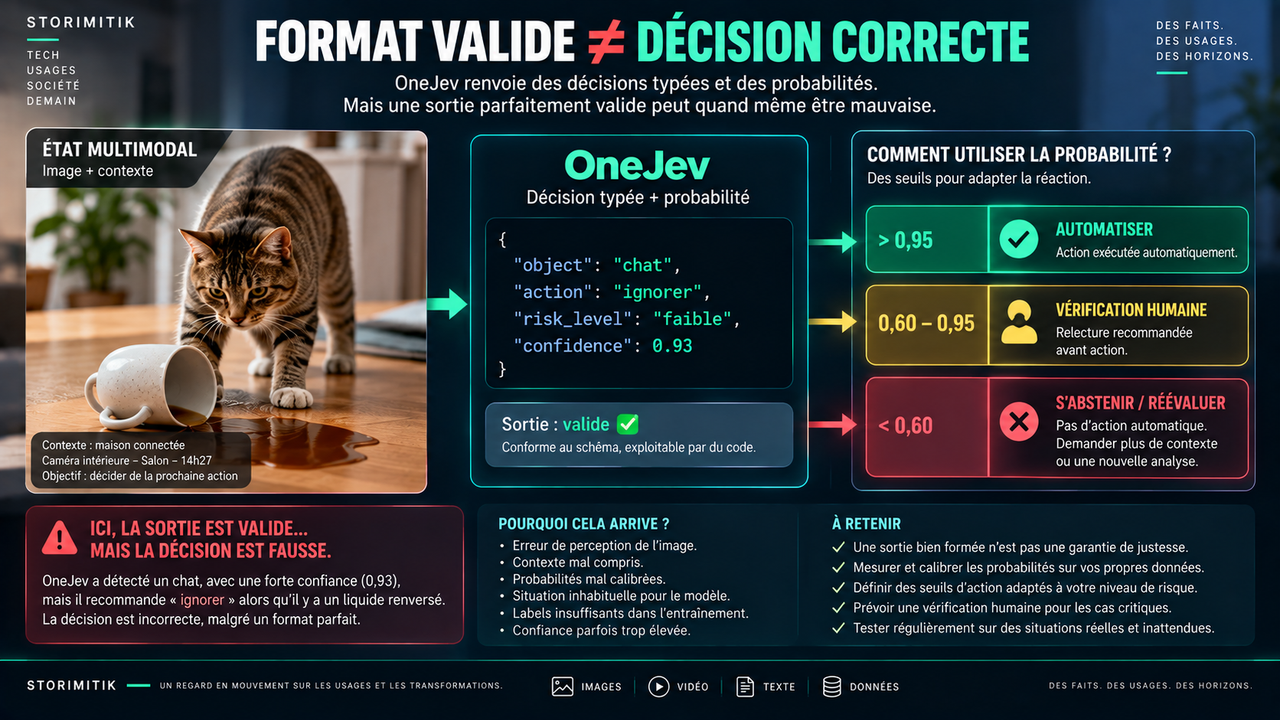
Les probabilités n’ont d’ailleurs de valeur opérationnelle que si elles sont calibrées sur le domaine réel. Un score de 0,93 ne doit pas être interprété mécaniquement comme « 93 % de chances d’avoir raison » tant que cette calibration n’a pas été mesurée sur des données représentatives de l’application.
La vidéo est une suite d’images, pas une mémoire infinie
Le support vidéo doit également être lu précisément. L’API OneJev reçoit des frames vidéo accompagnées d’un framerate ; il ne faut donc pas confondre cela avec un modèle qui observerait en continu un flux illimité avec une mémoire temporelle permanente.
Pour de la surveillance, du jeu ou de la robotique, l’échantillonnage des images, la mémoire entre appels et les règles de lissage restent des choix d’architecture à construire autour du modèle.
Pourquoi cette idée dépasse OneJev
TypeSafe défend la même intuition avec Jev : tous les problèmes d’IA ne nécessitent pas de générer du langage. Son modèle est présenté comme une fonction de décision : état non structuré en entrée, valeurs typées et probabilités en sortie.
Dans ses propres évaluations, TypeSafe revendique des gains allant jusqu’à 193,6 fois en vitesse et 444,6 fois en coût sur certains workflows System One. L’entreprise précise elle-même que ces gains se situent probablement dans le haut de la fourchette des cas réels.
TechCrunch rapporte déjà des essais où des développeurs utilisent Jev pour des classifications, du routage ou du contrôle d’agents. OneJev ajoute une dimension supplémentaire : rendre cette idée multimodale, ouverte et exécutable sur une infrastructure choisie par l’utilisateur.
Le futur de l’IA ne sera peut-être pas uniquement conversationnel
Les LLM restent beaucoup plus adaptés lorsqu’il faut écrire, expliquer, coder, chercher ou raisonner sur une tâche ouverte. OneJev ne les remplace pas. Il propose une autre brique, plus étroite : prendre rapidement de nombreuses microdécisions dont les options sont déjà connues.
C’est précisément ce qui rend ce projet intéressant. Après des années où presque toute l’IA grand public a été pensée comme une conversation, OneJev pose une autre question : et si, dans une grande partie des logiciels, la meilleure réponse était de ne rien dire du tout — juste renvoyer la bonne probabilité au bon endroit ?
Sources
- OneJev: A Multimodal System One Decision ModelOmniJev — GitHub · OmniJev Team · 28 septembre 2026
- OneJev-0.8BOmniJev — Hugging Face · OmniJev Team · 28 septembre 2026
- OmniJev model collectionOmniJev — Hugging Face · OmniJev Team · 28 septembre 2026
- Introducing System One Models & JevTypeSafe AI · Diogo Almeida / TypeSafe AI · 15 septembre 2026
- TypeSafe AI — System One Models and JevTypeSafe AI · TypeSafe AI
- A new kind of AI model from a ChatGPT inventor is thrilling developersTechCrunch · Tim Fernholz · 18 septembre 2026