
Storie DécryptageTech et IA
Un nouveau « meilleur modèle IA » sort presque chaque semaine. Le vrai avantage est peut-être d’arrêter de toujours choisir le dernier
Les modèles IA se succèdent à une vitesse telle que courir derrière le dernier numéro un devient difficilement tenable. Le vrai avantage pourrait désormais venir du workflow : choisir ou router chaque tâche vers le bon profil selon la qualité, la vitesse, le coût, la fiabilité et les contraintes réelles.
Par Florent Despréaux
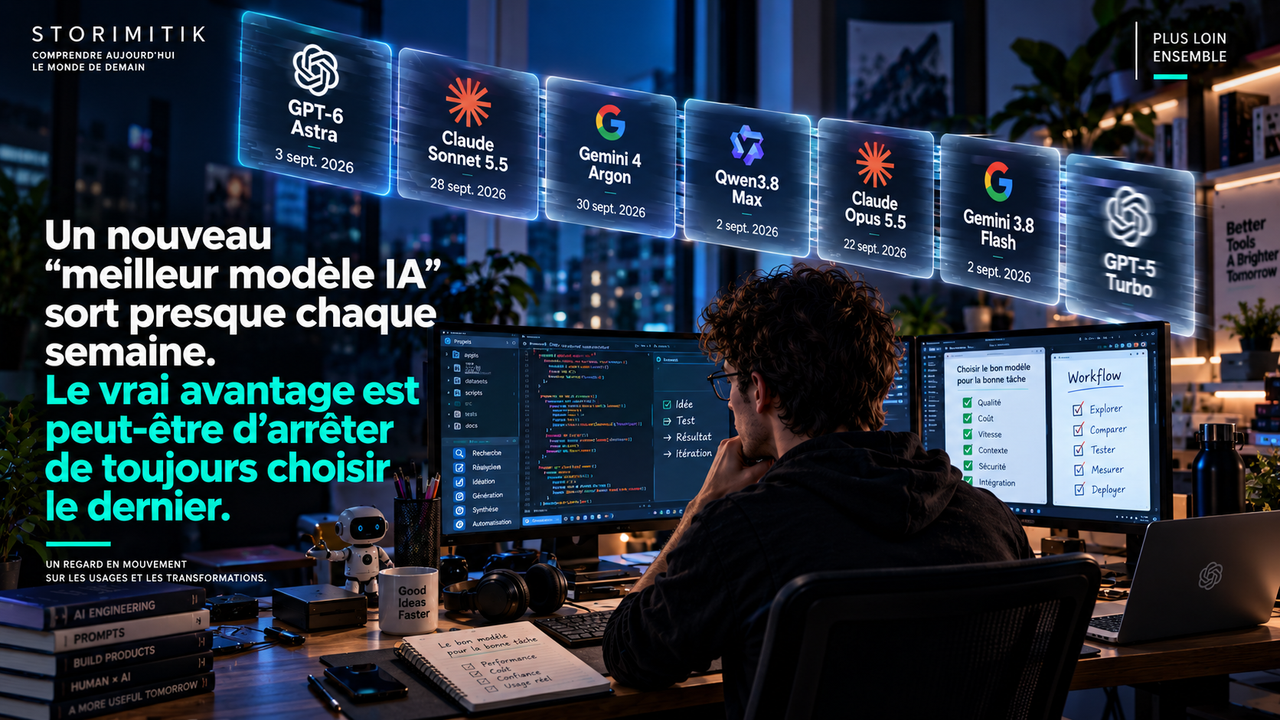
Pendant longtemps, suivre l’intelligence artificielle consistait à attendre quelques grands lancements par an. Ce rythme n’existe pratiquement plus.
En septembre 2026 seulement, les annonces se sont succédé à un rythme extrêmement élevé : Gemini 3.8 Flash, GPT‑6 Astra, Qwen3.8-Max, Claude Opus 5.5, Claude Sonnet 5.5 puis Gemini 4 Argon. Google souligne lui-même que Gemini 3.8 Flash constituait son troisième lancement Flash en six semaines.
À ce rythme, la vraie question n’est peut-être plus « quel est le meilleur modèle aujourd’hui ? », mais « quel modèle utiliser, pour quelle tâche, à quel coût et avec quel niveau de contrôle ? »
Le modèle le plus puissant est aussi souvent le plus cher
OpenAI positionne GPT‑6 Astra comme un modèle destiné aux travaux complexes : raisonnement, code, recherche, usage d’ordinateur et production de documents. Son tarif API standard documenté est de 10 dollars par million de tokens en entrée et 50 dollars en sortie.
La même plateforme propose aussi des modèles bien moins chers. Si une entreprise utilise systématiquement son modèle le plus puissant pour classer un email, résumer quelques lignes, reformater une fiche produit ou extraire quelques champs, elle achète potentiellement beaucoup plus de capacité qu’elle n’en a réellement besoin.
Les fabricants eux-mêmes structurent désormais leurs gammes par usage
Anthropic distingue explicitement ses modèles selon les usages. Sonnet 5.5 est présenté comme mieux adapté aux tâches quotidiennes bien cadrées, plus rapide et moins coûteux, tandis qu’Opus 5.5 vise les travaux plus complexes.
Google suit une logique comparable : Gemini 3.8 Flash est positionné comme un modèle général rapide, tandis que Gemini 4 Argon vise des problèmes complexes et de longue durée. Alibaba fait cohabiter des profils Max et Flash avec des écarts de coûts importants.
Une tâche de recherche n’a pas les mêmes contraintes qu’un bouton « Résumer »
Un même utilisateur peut, dans la même journée, avoir besoin de rechercher et sourcer une information, rédiger un texte, analyser un fichier de données, produire du code ou exécuter une automatisation. Ces tâches n’ont pas le même profil.
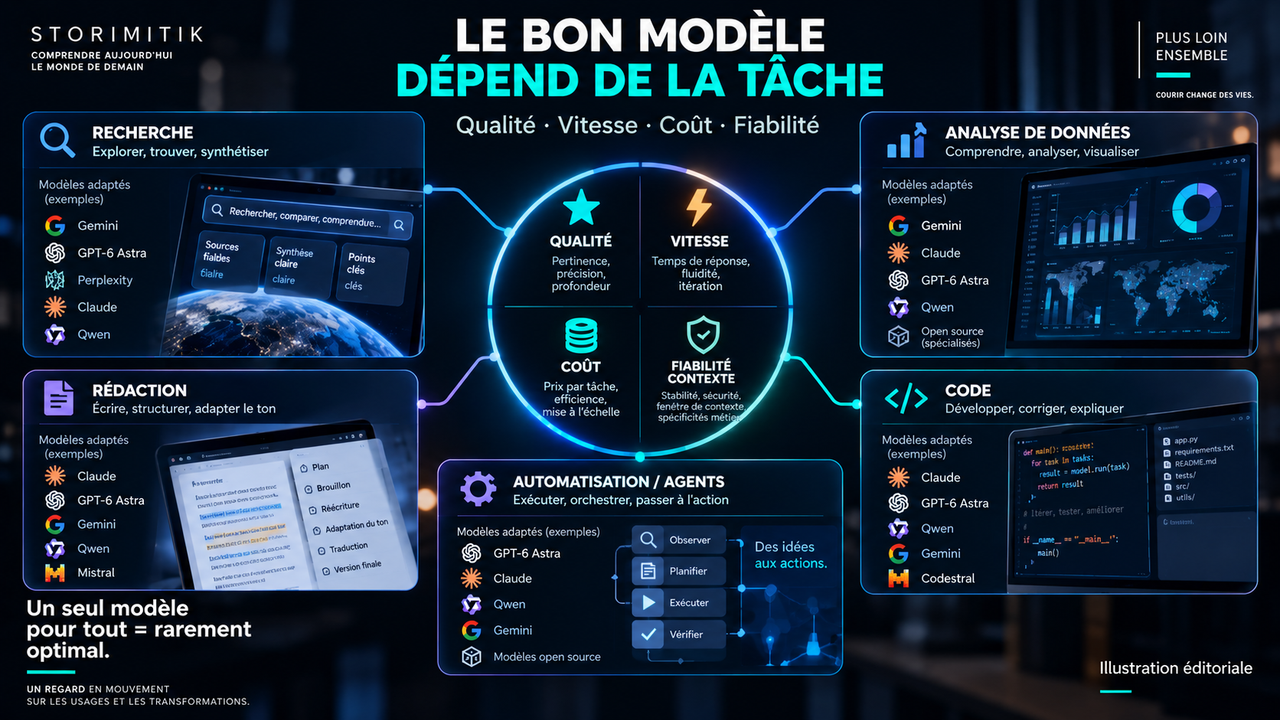
Pour une recherche, la capacité à trouver des sources récentes et à les citer peut compter davantage qu’un score abstrait de raisonnement. Pour le code, un modèle spécialisé peut apporter d’autres avantages : faible latence, compréhension d’un dépôt ou possibilités de déploiement privé.
Le benchmark ne connaît pas votre entreprise
Un benchmark peut mesurer une performance, mais il ne connaît pas votre budget, vos délais, vos données, votre architecture, vos exigences de confidentialité, votre tolérance à l’erreur ou votre volume de requêtes.
Deux modèles proches sur une évaluation peuvent donc avoir une valeur économique très différente. À l’inverse, un modèle théoriquement moins performant peut devenir le meilleur choix opérationnel parce qu’il répond plus vite, coûte beaucoup moins cher ou peut être hébergé dans l’environnement du client.
Le prochain avantage compétitif pourrait être le routeur
Au lieu de demander à un collaborateur de choisir manuellement parmi quinze modèles, un système peut recevoir une demande puis décider automatiquement quel profil utiliser : rapide et économique pour une tâche simple, raisonnement pour une analyse complexe, spécialisé pour du code, privé pour des données sensibles, agentique pour une action multi-étapes.
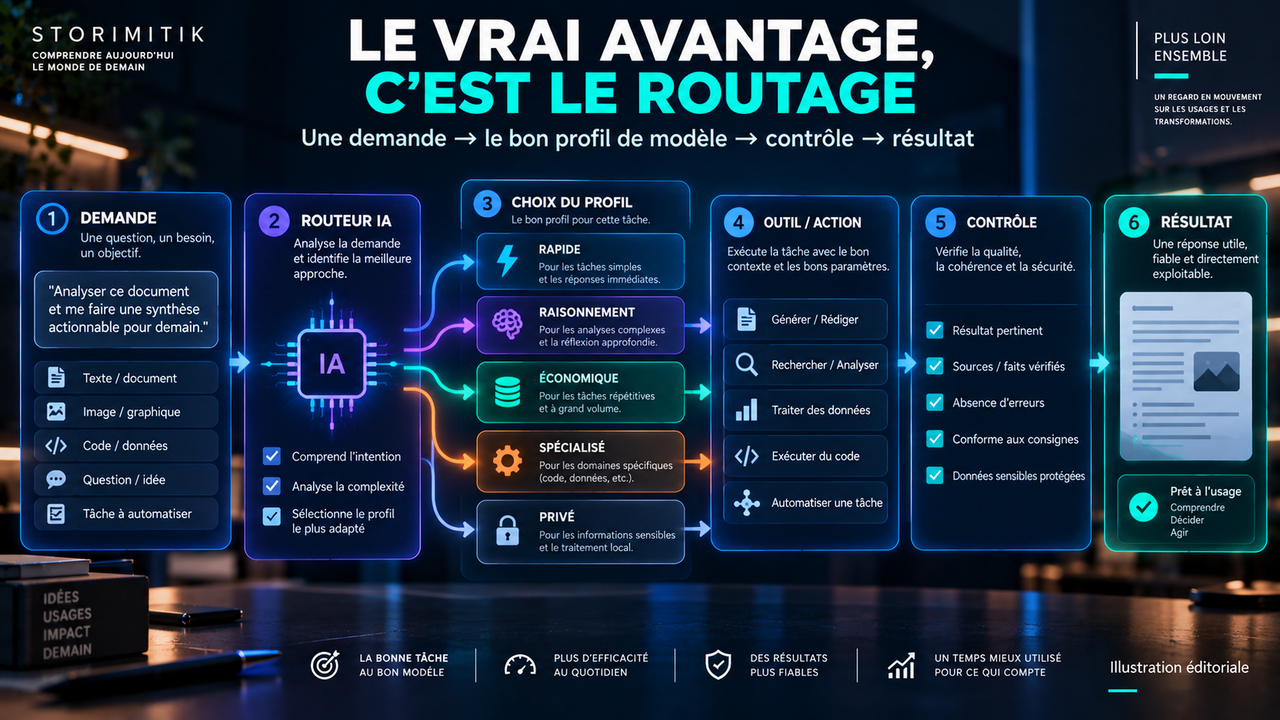
Le résultat passe ensuite par une couche de contrôle avant d’être livré. Le modèle n’est plus le produit : il devient une ressource interchangeable dans une architecture.
Le workflow devient plus important que le dernier modèle sorti
Si un nouveau modèle apparaît demain — plus rapide, moins cher, meilleur sur une tâche précise, disponible localement ou mieux adapté à certaines données — il faut pouvoir l’introduire sans reconstruire tout le produit.
Le véritable actif devient alors le workflow : les prompts, le contexte, les données, les outils, les règles de sélection, les contrôles, les évaluations et les mécanismes de retour en arrière. Le modèle choisi aujourd’hui peut changer ; le système qui sait quand l’utiliser reste.
La prochaine compétence IA : savoir ne pas utiliser le meilleur modèle
Pendant les premières années de l’IA générative, utiliser le modèle le plus puissant disponible était souvent une stratégie rationnelle. Mais à mesure que les familles de modèles se multiplient et que les performances convergent sur de nombreuses tâches quotidiennes, cette logique devient moins évidente.
Le bon réflexe devient alors de commencer par la tâche, pas par le modèle : définir le niveau de qualité attendu, déterminer les contraintes de coût, de rapidité, de confidentialité et d’intégration, puis choisir — ou laisser le système choisir — le profil approprié.
Le « meilleur modèle » devient une mauvaise abstraction
Les modèles continueront de sortir et les classements continueront de changer. Mais pour celui qui construit un véritable usage, la question centrale pourrait devenir beaucoup plus stable : quel est le modèle suffisamment bon pour cette tâche précise ?
Le vrai avantage compétitif ne sera peut-être plus de courir derrière chaque sortie, mais de construire un système dans lequel le modèle peut changer sans que le travail, lui, s’arrête.
Sources
- GPT-6 Astra — Model documentationOpenAI · OpenAI
- API pricingOpenAI · OpenAI
- Claude Sonnet 5.5Anthropic · Anthropic · 28 septembre 2026
- Claude Opus 5.5Anthropic · Anthropic · 22 septembre 2026
- Gemini 3.8 Flash and Gemini 3.8 Flash CyberGoogle · Google · 2 septembre 2026
- Gemini 4 ArgonGoogle · Google · 30 septembre 2026
- Model pricing — Model StudioAlibaba Cloud · Alibaba Cloud
- ResearchPerplexity · Perplexity
- CodestralMistral AI · Mistral AI