Storie DécryptageTech et IA
Votre IA a une jauge invisible : tokens, contexte, coût… ce que votre écran ne vous montre pas
Vous posez une question courte, mais l’IA peut traiter bien davantage : contexte, historique pertinent, fichiers, outils, sortie et parfois raisonnement interne. Les tokens forment déjà une véritable comptabilité de cet usage — sans pour autant constituer une mesure directe de l’énergie.
Par Florent Despréaux
Date d’observation :
Vous écrivez une question de dix mots. Quelques secondes plus tard, une IA répond. À l’écran, rien ne ressemble à une jauge : pas de compteur qui descend, pas de réservoir qui se vide, pas de coût qui défile en temps réel.
Pourtant, sous cette interface très simple, le système compte déjà quelque chose : des tokens. Ils servent à mesurer ce que le modèle reçoit, ce qu’il génère et, selon les modèles, une partie du raisonnement interne qui n’apparaît jamais dans la réponse visible.
C’est la jauge cachée de l’intelligence artificielle. Pas une jauge d’énergie au sens physique, mais une unité de comptabilité qui relie directement contexte, limites techniques et, dans les API, coût d’utilisation.
La jauge existe déjà — elle n’est simplement pas sur le tableau de bord
Dans l’API OpenAI, chaque réponse peut indiquer précisément le nombre de tokens d’entrée, de sortie et le total utilisé. Selon le modèle et l’endpoint, le relevé peut également distinguer les tokens d’entrée mis en cache et les tokens de raisonnement.
Autrement dit, le compteur n’est pas une métaphore inventée pour expliquer l’IA : il existe réellement dans l’infrastructure. Ce qui manque souvent dans l’expérience utilisateur, c’est son équivalent visuel simple.
On pourrait imaginer un tableau de bord affichant quatre lignes : contexte reçu, contexte réutilisé depuis le cache, tokens générés et tokens de raisonnement. Pour un développeur, ces catégories existent déjà. Pour l’utilisateur final, elles restent généralement derrière l’interface.
Un token n’est pas un mot
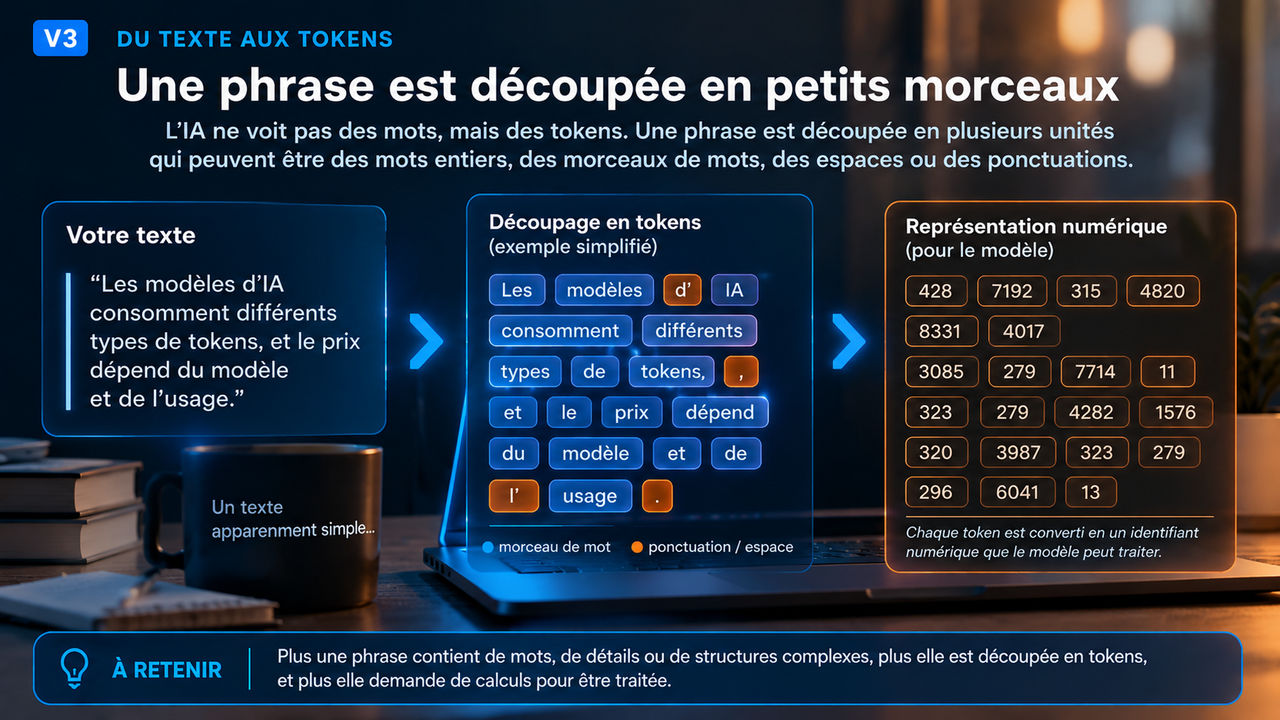
Un token est une unité utilisée par le modèle pour traiter le langage. Il peut correspondre à un caractère, un morceau de mot, un mot entier ou un signe de ponctuation. Les espaces influencent aussi la tokenisation.
Le nombre de tokens n’est donc pas égal au nombre de mots. Il varie avec la langue, le modèle et son encodage. Deux modèles peuvent découper exactement le même texte différemment.
Cette distinction paraît technique, mais elle devient très concrète dès qu’un service facture ou limite l’usage en tokens : la longueur visible du texte n’est plus la seule chose qui compte.
Une question courte peut cacher une requête beaucoup plus longue
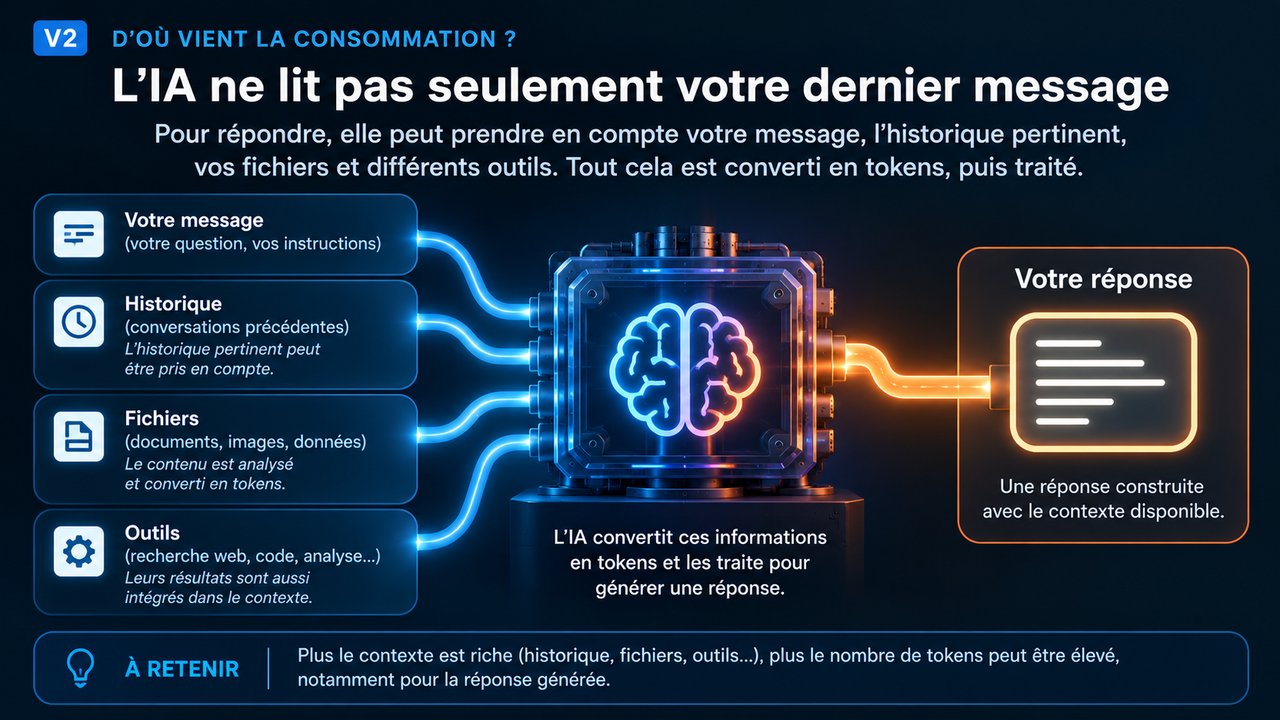
Le point le plus contre-intuitif est probablement celui-ci : votre dernier message n’est pas forcément tout ce que le modèle reçoit.
Selon le produit et la manière dont la conversation est gérée, le contexte peut inclure des messages précédents, des résultats d’outils, des fichiers, des images, des instructions ou d’autres éléments nécessaires pour poursuivre la tâche. L’API OpenAI de comptage des entrées accepte précisément ces différents types de contenu.
Dans une conversation chaînée via l’API Responses, OpenAI précise même que les tokens d’entrée issus des réponses précédentes restent comptabilisés dans l’usage. Une question très courte peut donc s’inscrire dans un contexte beaucoup plus volumineux.
Cela ne signifie pas que l’intégralité brute de l’historique est toujours renvoyée indéfiniment. Les applications peuvent sélectionner le contexte, le gérer différemment ou le compacter. OpenAI propose par exemple un mécanisme de compaction qui réduit la taille du contexte tout en conservant l’état utile pour poursuivre une conversation longue.
La réponse que vous voyez n’est pas forcément toute la sortie
Avec certains modèles de raisonnement, une partie du travail se déroule sous forme de tokens de raisonnement internes. Ils ne sont pas affichés dans le texte final, mais OpenAI indique qu’ils sont comptabilisés dans l’utilisation de sortie et facturés comme des tokens de sortie.
Conséquence : une réponse visible courte peut représenter davantage de consommation de tokens que ce que sa longueur laisse croire.
À l’inverse, certains tokens d’entrée peuvent être servis depuis un cache et bénéficier d’un tarif différent. Le compteur moderne n’a donc plus seulement deux aiguilles — entrée et sortie — mais plusieurs catégories.
Pourquoi cette jauge devient aussi une jauge de coût
Dans une API facturée à l’usage, chaque catégorie a un prix. Au 5 octobre 2026, OpenAI affiche pour GPT-5.4 un tarif de 2,50 dollars par million de tokens d’entrée, 0,25 dollar pour les entrées mises en cache et 15 dollars par million de tokens de sortie.
Sur cet exemple précis, un million de tokens de sortie coûte donc six fois plus qu’un million de tokens d’entrée standard. Ce ratio n’est pas universel : les prix changent selon le modèle, le fournisseur et parfois la taille du contexte.
Les outils peuvent également ajouter leur propre coût. Une recherche, un appel à un service externe ou une fonctionnalité spécialisée ne se résume pas nécessairement au seul prix des tokens.
Cette logique concerne la facturation de l’API. Elle ne doit pas être confondue avec un abonnement ChatGPT grand public : OpenAI indique que ChatGPT et la plateforme API ont des systèmes de facturation séparés.
Mais un token n’est pas un wattheure
C’est la limite la plus importante de l’analogie avec le carburant. Compter les tokens ne permet pas, à lui seul, de convertir proprement une conversation en consommation électrique.
L’énergie dépend du modèle utilisé, de son architecture, du matériel, de la longueur du contexte, du nombre de tokens générés, du traitement par lots et de la manière dont l’infrastructure sert les requêtes. Des travaux récents sur des GPU H100 et H200 montrent justement que l’énergie par token peut varier fortement selon ces paramètres.
L’Agence internationale de l’énergie arrive à la même conclusion à l’échelle des usages : l’efficacité énergétique par tâche d’IA progresse rapidement, mais les usages ne se valent pas. Les tâches de raisonnement, les agents ou la génération vidéo peuvent consommer des centaines, voire des milliers de fois plus d’énergie par requête qu’une simple génération de texte.
La bonne formulation est donc : plus de tokens signifie généralement davantage de traitement, mais il n’existe pas de conversion universelle du type « un token = X wattheure ». Une jauge énergétique crédible devrait être mesurée par l’infrastructure elle-même, pas déduite avec une constante magique.
La fenêtre de contexte est la vraie capacité du réservoir
Chaque modèle possède aussi une fenêtre de contexte : la quantité maximale d’information qu’il peut prendre en compte dans une requête, en incluant selon les cas entrée, sortie et raisonnement.
Cette capacité varie fortement d’un modèle à l’autre. Elle explique pourquoi une conversation, un dossier ou un agent ne peut pas accumuler indéfiniment des informations sans stratégie de sélection ou de compaction.
Le parallèle automobile devient alors assez parlant : les tokens sont l’unité comptée, la fenêtre de contexte fixe la capacité maximale disponible, et le système de facturation indique combien cette utilisation coûte. Mais contrairement à une voiture, la jauge complète est rarement réunie dans un seul cadran.
À quoi ressemblerait une vraie jauge utile ?
Pour être réellement informative, elle devrait distinguer au minimum les tokens d’entrée, les tokens d’entrée mis en cache, les tokens de sortie et, lorsque le modèle en utilise, les tokens de raisonnement.
Elle pourrait également afficher l’occupation de la fenêtre de contexte, le coût API estimé, les appels d’outils et une indication de ce qui a été compacté ou retiré du contexte.
L’énergie devrait rester une donnée séparée, fournie seulement lorsqu’elle peut être mesurée ou estimée avec une méthodologie documentée.
Une telle interface ferait apparaître une réalité aujourd’hui facile à oublier : une question n’est pas seulement une phrase envoyée à une machine. C’est une requête qui mobilise un contexte, une capacité de calcul et parfois plusieurs services.
Réduire la consommation sans rendre l’IA moins utile
La meilleure optimisation n’est pas de supprimer du contexte au hasard. C’est d’enlever ce qui n’est plus utile.
Une conversation devenue très longue peut être résumée ou compactée. Un fichier entier peut être remplacé par les passages pertinents. Une réponse peut être demandée plus concise. Un nouvel échange peut repartir d’un contexte propre lorsque l’ancien sujet n’a plus aucune utilité.
Pour un développeur, ces choix jouent directement sur coût et latence. Pour un utilisateur, ils améliorent aussi la lisibilité de la tâche : moins de bruit, davantage d’informations réellement pertinentes.
La bonne question n’est donc pas « comment utiliser le moins de tokens possible ? ». C’est plutôt : « quels tokens apportent réellement de la valeur à la réponse ? »
Le compteur existe. Il reste à installer la jauge.
Les IA génératives donnent l’impression d’un service immatériel : une zone de texte, quelques secondes d’attente, puis une réponse.
En réalité, chaque échange possède déjà une comptabilité précise. Le texte est tokenisé. Le contexte occupe une capacité limitée. Les sorties sont comptées. Le raisonnement peut ajouter une consommation invisible. Les API transforment ensuite cette comptabilité en prix.
Ce que l’utilisateur ne voit pas encore toujours, c’est le tableau de bord qui relie toutes ces informations.
La jauge de l’IA n’est donc pas à inventer. Elle existe déjà sous le capot. Il reste surtout à décider quand il devient utile de la montrer.
Sources
- Comprendre et compter les tokensOpenAI Help Center · OpenAI
- Conversation stateOpenAI API · OpenAI
- CompactionOpenAI API · OpenAI
- GPT-5.4 ModelOpenAI API · OpenAI
- Gestion de la facturation pour ChatGPT et la plateforme APIOpenAI Help Center · OpenAI
- Understand and count tokens — Gemini APIGoogle AI for Developers · Google
- Key Questions on Energy and AI — Executive summaryInternational Energy Agency · IEA
- Characterization of Request and Token Energy Costs for LLM Inference Workloads on GPU PlatformsarXiv · Prabhu Vellaisamy, Vanessa Lam, Shawn Blanton, John Paul Shen · 28 août 2026