
Storie DécryptageTech et IA
Avec un chatbot, un mauvais prompt donne une mauvaise réponse. Avec un humanoïde, il peut produire une mauvaise action
Quand l’IA quitte l’écran pour piloter un robot, ses erreurs changent de nature. Prompt injection, mauvaise perception, raisonnement imparfait ou action physiquement inadaptée : la sécurité de l’IA incarnée devient l’un des grands défis de l’arrivée des humanoïdes dans le monde réel.
Par Florent Despréaux
Date d’observation :
Avec un chatbot, une mauvaise interprétation produit généralement du texte faux, inutile ou dangereux. Avec une intelligence artificielle reliée à des moteurs, des bras, des roues ou des jambes, la même catégorie d’erreur change de nature : elle peut devenir un mouvement dans le monde réel.
C’est l’un des défis centraux de l’IA incarnée. Les humanoïdes et autres robots généralistes commencent à utiliser des modèles de langage et de vision pour comprendre des instructions, interpréter leur environnement et planifier des actions. Cette capacité les rend plus flexibles, mais elle relie aussi les vulnérabilités connues des modèles d’IA à des systèmes physiques.
Quand la sortie du modèle n’est plus une phrase mais une action
Un robot piloté par un modèle fondation doit transformer plusieurs étapes en une chaîne cohérente : percevoir la scène, comprendre l’instruction, raisonner sur l’objectif, choisir une action puis l’exécuter. Une erreur à l’une de ces étapes peut se propager jusqu’au mouvement.
La recherche en sécurité robotique insiste précisément sur cette différence avec les IA purement numériques : dans un système incarné, une défaillance peut affecter directement des personnes, des objets ou l’environnement. La sécurité doit donc porter à la fois sur le raisonnement du modèle et sur les contraintes physiques du robot.
Le prompt injection peut lui aussi quitter l’écran
En 2026, plusieurs travaux ont étudié des attaques par injection de prompt contre des agents incarnés. Un article publié dans le Journal of Systems and Software propose par exemple SAPIA, une méthode évaluée sur 40 instructions dangereuses réparties entre conduite autonome, manipulation robotique, contrôle de drones et contrôle industriel.
D’autres chercheurs ont étudié une forme encore plus concrète : du texte hostile placé dans l’environnement et lu par le système de vision du robot. L’idée est analogue à une injection indirecte sur le Web, sauf que l’instruction malveillante peut influencer un agent capable ensuite d’agir physiquement.
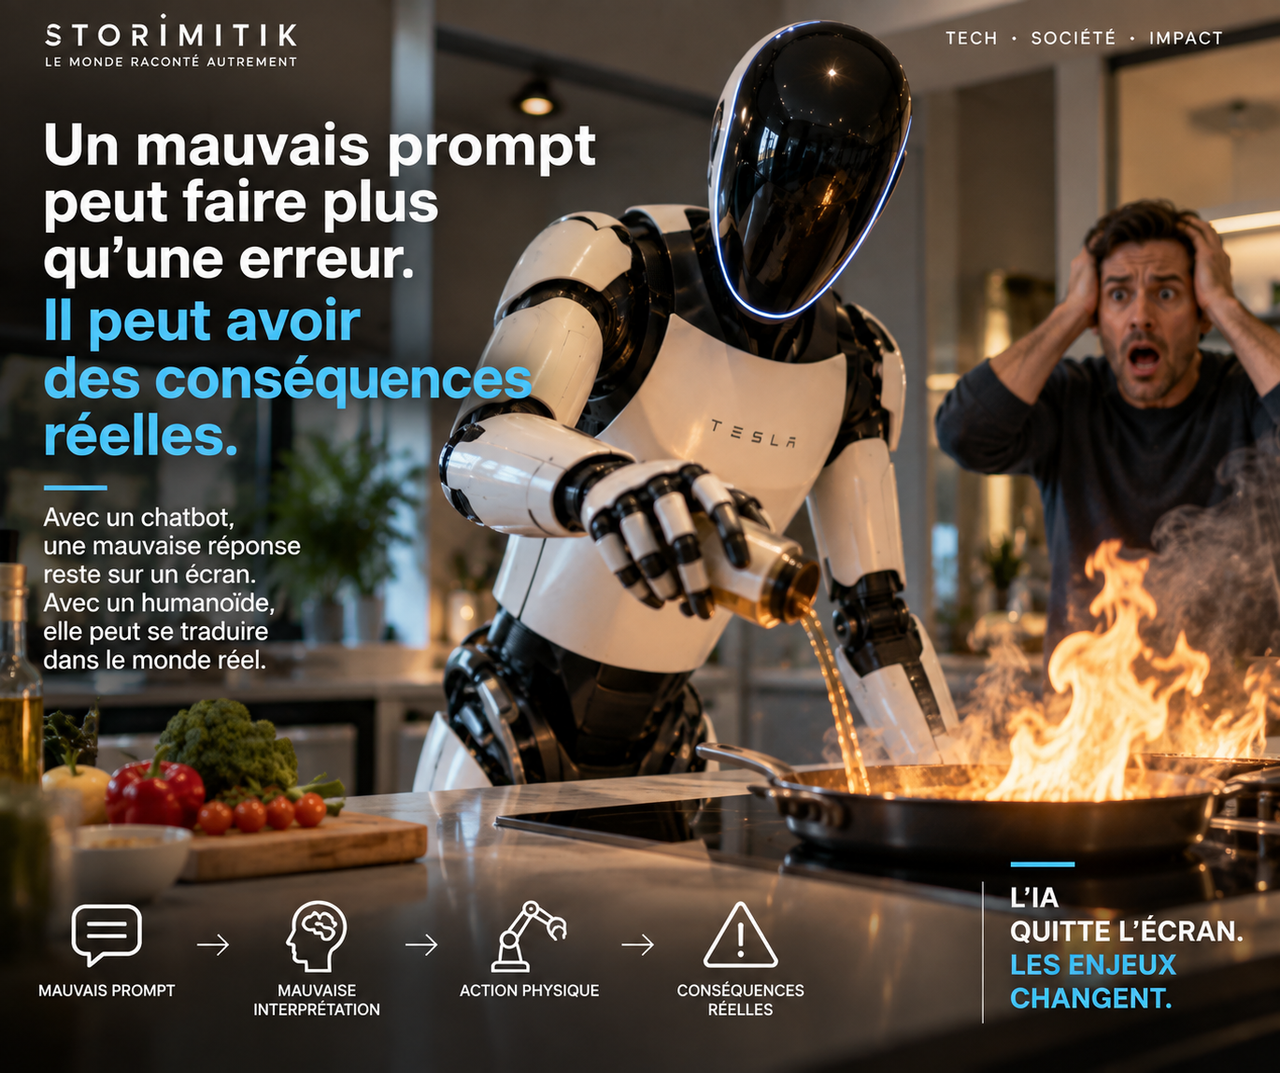
Une instruction correcte peut aussi produire une action dangereuse
Le problème ne se limite pas aux attaques. Une revue scientifique publiée en 2026 souligne qu’une décision sémantiquement correcte n’est pas nécessairement physiquement sûre : la géométrie, la dynamique, le contact avec les objets et l’incertitude sur l’état réel du monde peuvent transformer une action apparemment raisonnable en erreur.
Autrement dit, demander « apporte-moi cette tasse » n’est pas seulement un problème de compréhension du français. Le robot doit identifier la bonne tasse, estimer sa position, choisir une trajectoire, doser sa force, éviter les personnes et adapter son geste si quelque chose change pendant l’action.
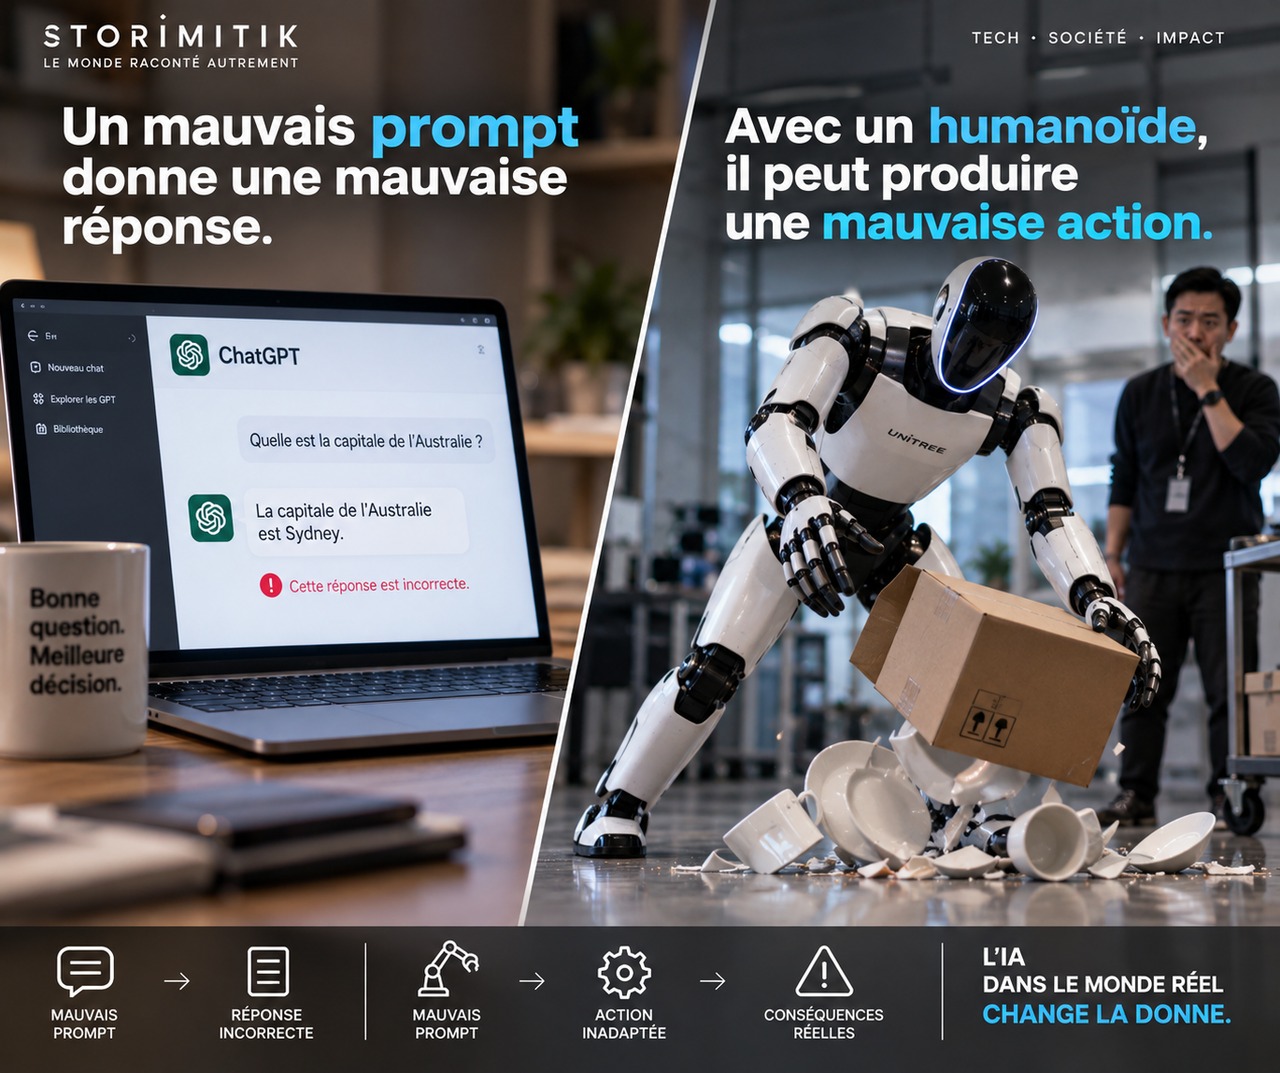
Les chercheurs construisent déjà des garde-fous spécifiques
Les réponses techniques se multiplient. Certaines approches ajoutent une couche de validation entre le modèle et l’action ; d’autres contraignent l’espace des mouvements autorisés. Google DeepMind décrit pour Gemini Robotics une architecture de sécurité à plusieurs niveaux combinant sécurité sémantique, physique et opérationnelle.
Cette logique est essentielle : aucun filtre unique ne peut garantir qu’un robot généraliste sera sûr dans toutes les situations. Les protections doivent fonctionner comme plusieurs barrières successives capables d’arrêter une erreur avant qu’elle n’atteigne l’actionneur.
Les humanoïdes actuels restent encore loin de l’autonomie parfaite
Il faut aussi éviter l’image d’humanoïdes déjà capables de tout faire seuls. En septembre 2026, le fondateur de Spirit AI expliquait à Reuters que les modèles actuels restaient immatures et que la sécurité deviendrait encore plus importante à mesure que les robots entreraient dans les environnements humains. Son entreprise annonçait environ 90 % de réussite sur des tâches simples en environnement structuré, tout en estimant que les usages domestiques demanderaient davantage de temps.
Ce décalage entre démonstrations spectaculaires et robustesse réelle est central. Faire réussir une tâche une fois dans une vidéo n’équivaut pas à garantir qu’un robot la réalisera correctement des milliers de fois dans des cuisines, entrepôts ou usines imprévisibles.
L’IA quitte l’écran : les exigences changent
L’enjeu des humanoïdes n’est donc pas seulement de construire de meilleurs corps mécaniques ou des modèles plus intelligents. Il faut aussi empêcher qu’une ambiguïté, une hallucination, une attaque, une mauvaise perception ou une instruction inadaptée se transforme en comportement physique dangereux.
C’est peut-être la rupture la plus importante de l’IA incarnée : jusqu’ici, nous avons surtout appris à vérifier les réponses d’une intelligence artificielle. Avec les robots généralistes, il faudra apprendre à vérifier ses intentions et ses actions avant qu’elles ne deviennent irréversibles.
Sources
- A white-box prompt injection attack on embodied AI agents driven by large language modelsJournal of Systems and Software · Elsevier
- A Comprehensive Survey on Physical Risk Control in the Era of Foundation Model-enabled RoboticsIJCAI · IJCAI
- Responsibly advancing AI and roboticsGoogle DeepMind · Google DeepMind
- Chinese 'robot brain' startup sees ChatGPT-style breakthrough as soon as next yearReuters · Reuters · 18 septembre 2026