
Storie DécryptageTech et IA
GPT‑6 Astra atteint presque 100 % sur un benchmark conçu pour tester l’intelligence générale. Alors, l’AGI est-elle arrivée ?
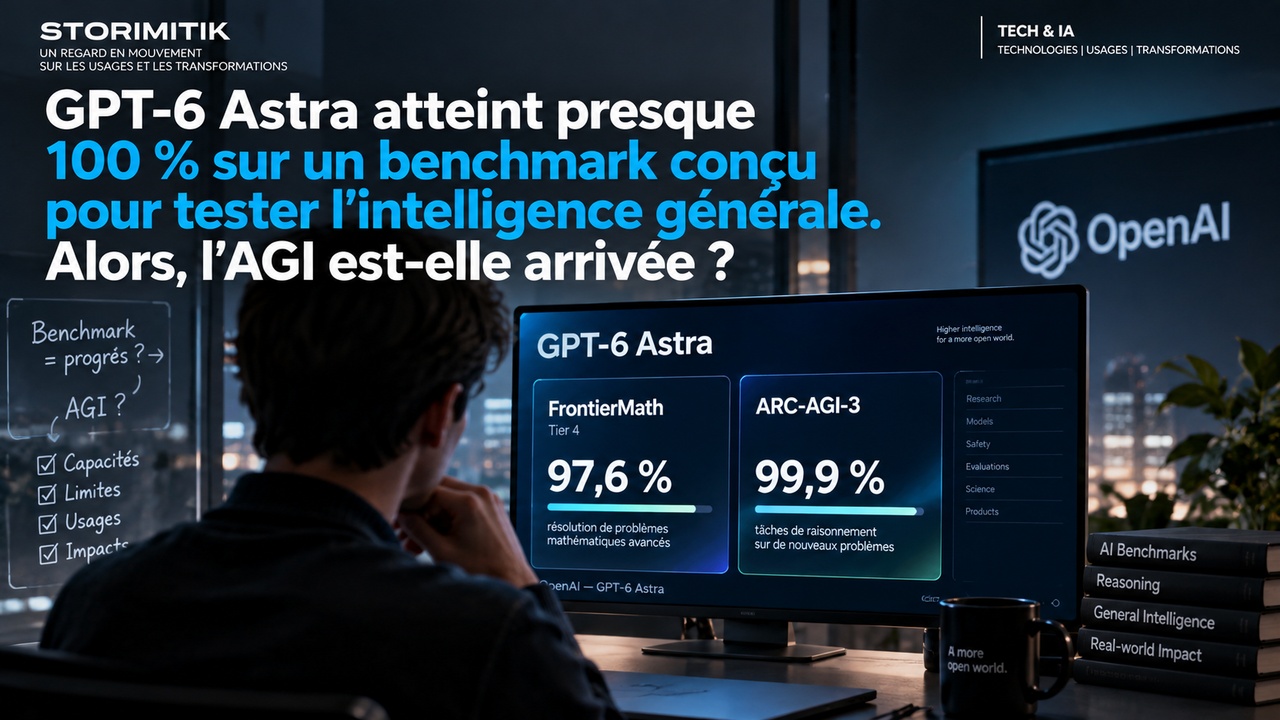
OpenAI publie 97,6 % sur FrontierMath Tier 4 et 99,9 % sur ARC‑AGI‑3 pour GPT‑6 Astra. Mais ARC Prize mesure aussi 62,7 % avec un protocole différent. Derrière les scores presque parfaits se cache une question plus importante : que prouve réellement un benchmark lorsqu’il dépend autant de la manière dont on l’exécute ?
Par Florent Despréaux
Presque 100 % sur les benchmarks : spectaculaire, mais pas une définition de l’AGI
GPT‑6 Astra affiche des scores qui donnent l’impression qu’une frontière vient d’être franchie : 97,6 % sur FrontierMath Tier 4 et 99,9 % sur ARC‑AGI‑3 dans les résultats publiés par OpenAI.
Pris isolément, ces nombres sont vertigineux. ARC‑AGI‑3 a justement été conçu pour tester une forme d’intelligence adaptative dans des environnements nouveaux où le système doit explorer, comprendre ce qui se passe, identifier un objectif et construire une stratégie sans recevoir les règles à l’avance.
Mais un score proche de 100 % ne signifie pas automatiquement que l’intelligence artificielle générale — l’AGI — est arrivée. La première raison est simple : un benchmark mesure ce qu’il a été conçu pour mesurer, dans un protocole précis.
Le même modèle peut passer de 62,7 % à 98,6 %
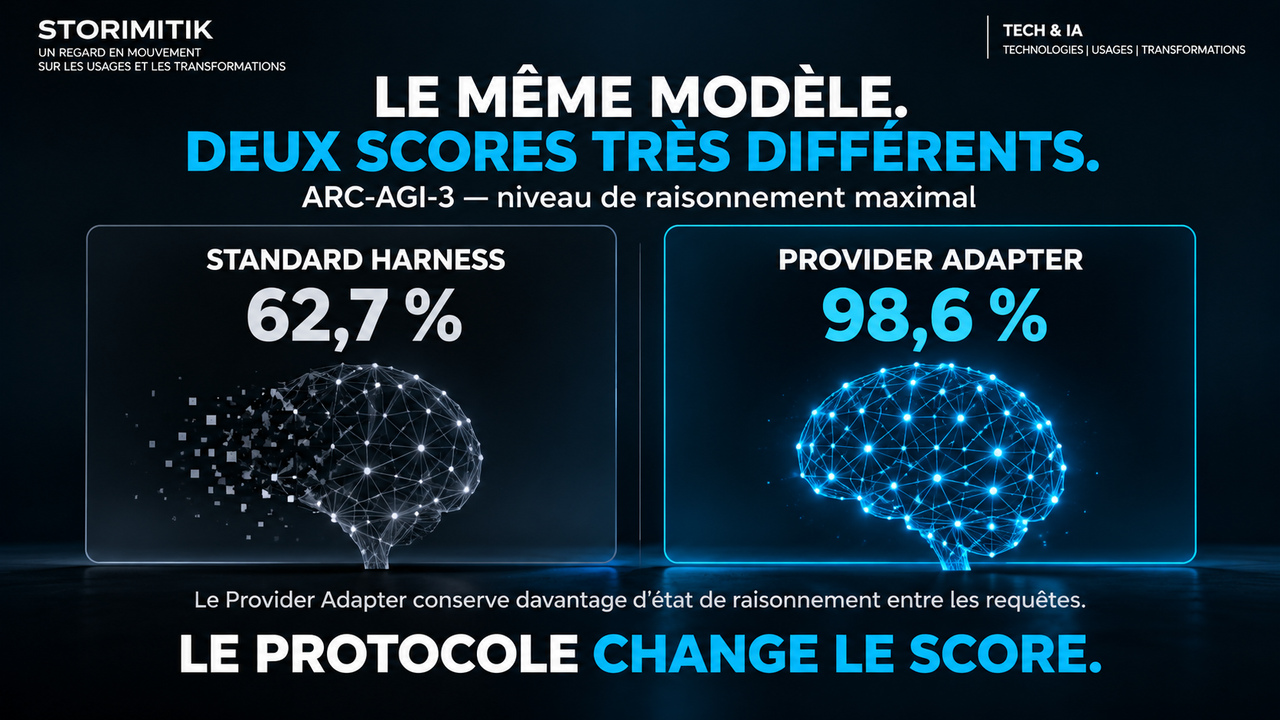
ARC Prize fournit ici une démonstration particulièrement utile. Sur l’évaluation semi-privée ARC‑AGI‑3, GPT‑6 Astra obtient 62,71 % au niveau de raisonnement Max avec le Standard harness.
Avec le Provider Adapter, qui conserve davantage d’état de raisonnement opaque entre les requêtes et compacte les conversations longues, le même niveau Max atteint 98,55 %. Au niveau High, ce protocole monte même à 99,95 %.
Autrement dit, la performance ne dépend pas uniquement du modèle. Elle dépend aussi de la manière dont on lui permet de conserver son raisonnement, de gérer son contexte et d’interagir avec l’environnement.
Ce n’est pas un détail méthodologique : lorsque les benchmarks approchent de la saturation, le protocole devient une partie de plus en plus importante du résultat.
Que mesure vraiment ARC‑AGI‑3 ?
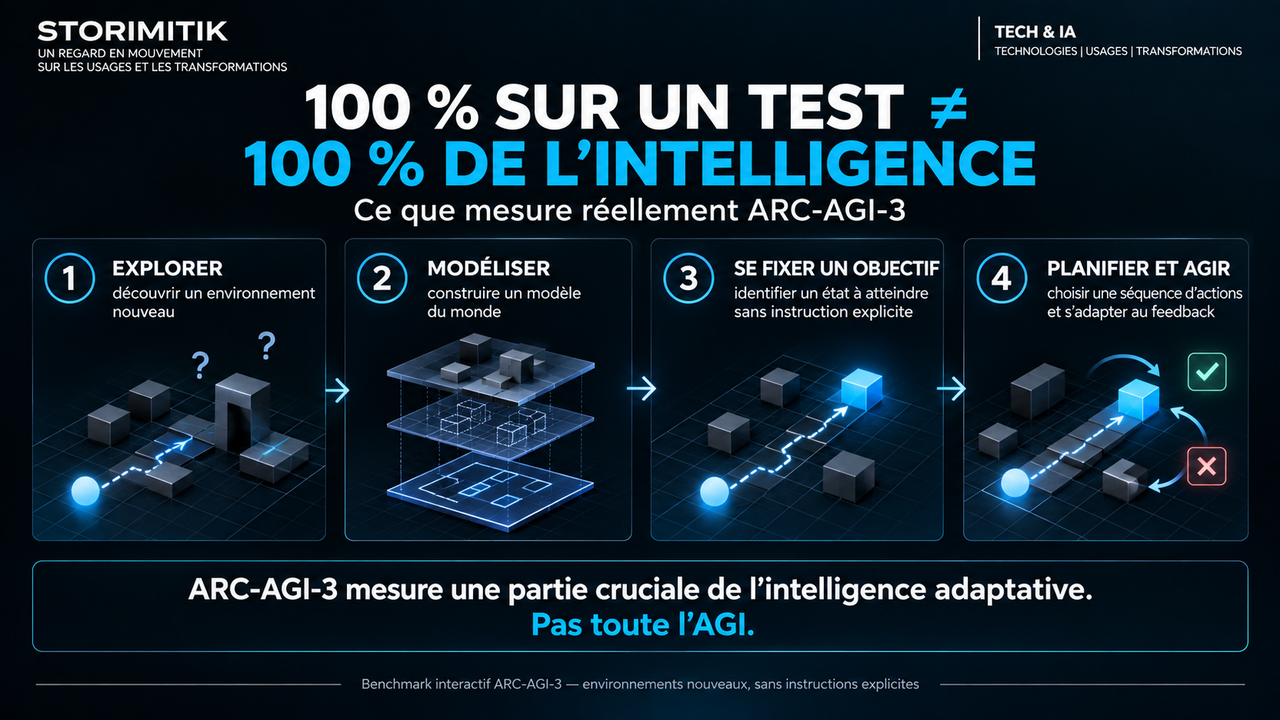
ARC‑AGI‑3 abandonne le format classique de questions-réponses. Le modèle est placé dans des environnements abstraits et interactifs qu’il n’a jamais vus auparavant.
Il doit d’abord explorer. Aucune notice ne lui explique nécessairement les règles, les objets pertinents ou la condition de réussite.
Il doit ensuite construire un modèle interne du monde : comprendre quelles actions produisent quels effets, quels éléments changent et quelles régularités gouvernent l’environnement.
Il doit également inférer l’objectif à atteindre, puis planifier une séquence d’actions efficace et l’adapter au retour obtenu après chaque étape.
C’est précisément ce qui rend le résultat important
Au lancement d’ARC‑AGI‑3 en mars 2026, les systèmes d’IA de pointe testés par les auteurs obtenaient moins de 1 % sur le benchmark, alors que les participants humains parvenaient à résoudre l’ensemble des environnements évalués.
Quelques mois plus tard, Astra est capable de transformer des environnements inconnus en représentations symboliques compactes, d’inférer leurs mécanismes et de planifier des actions avec une efficacité parfois supérieure à celle du participant humain médian.
Cette progression est réelle et spectaculaire. Elle montre que les modèles ne se contentent plus seulement de reconnaître des motifs ou de répondre à des questions déjà structurées : ils deviennent beaucoup plus capables de découvrir les règles d’un problème pendant qu’ils l’affrontent.
Pourquoi cela ne suffit toujours pas pour dire « AGI »
Le terme AGI n’a pas de définition unique et universellement acceptée. Certains l’utilisent pour désigner une intelligence capable de rivaliser avec l’humain sur une très grande variété de tâches intellectuelles ; d’autres insistent sur l’autonomie, l’apprentissage continu, la robustesse, le transfert entre domaines ou encore la capacité à fonctionner dans le monde réel.
ARC‑AGI‑3 cible volontairement une dimension plus étroite : l’efficacité de l’adaptation à des tâches nouvelles. Il évite notamment le langage et les connaissances externes pour isoler davantage cette capacité.
Un système peut donc devenir exceptionnel sur ARC‑AGI‑3 sans démontrer à lui seul toutes les propriétés que chacun pourrait associer à une intelligence générale : mémoire durable, fiabilité dans tous les domaines, autonomie prolongée, compréhension sociale, jugement, apprentissage continu ou interaction physique.
FrontierMath raconte la même histoire sous un autre angle
Sur FrontierMath Tier 4, qui rassemble des problèmes mathématiques extrêmement difficiles, OpenAI publie un score de 97,6 % pour Astra. Là encore, le saut de performance est remarquable.
Mais réussir presque tous les problèmes d’un benchmark mathématique ne transforme pas automatiquement un système en intelligence universelle. Cela démontre d’abord une capacité extrêmement élevée sur le domaine et le protocole considérés.
La saturation progressive des benchmarks crée donc un paradoxe : plus les modèles deviennent performants, moins le chiffre final suffit à expliquer ce qu’ils savent réellement faire.
Après les scores, le nouveau défi est de mesurer la généralisation
Pendant des années, l’industrie a pu suivre les progrès de l’IA en regardant les scores monter. Lorsque ceux-ci approchent de 100 %, cette lecture devient moins informative.
La prochaine génération d’évaluations devra davantage mesurer ce qui se passe hors distribution : problèmes réellement nouveaux, environnements imprévus, autonomie sur la durée, coûts, robustesse aux changements de protocole et capacité à transférer un apprentissage vers des situations très différentes.
Le cas Astra montre donc deux choses à la fois. D’un côté, les capacités de raisonnement adaptatif ont franchi un niveau qui aurait semblé improbable quelques mois plus tôt. De l’autre, la différence entre 62,7 % et près de 100 % rappelle qu’un benchmark n’est jamais indépendant de la façon dont on l’utilise.
La question n’est peut-être plus seulement « quel score atteint l’IA ? », mais « que reste-t-il à mesurer lorsque presque tous les scores atteignent le plafond ? »
Sources
- GPT-6 Astra: A new generation of intelligenceOpenAI · OpenAI
- OpenAI's GPT-6 Astra on ARC-AGI-3ARC Prize · Greg Kamradt / ARC Prize · 3 septembre 2026
- GPT-6 Astra — ARC-AGI ResultsARC Prize Results · ARC Prize
- ARC-AGI-3: A New Challenge for Frontier Agentic IntelligenceARC-AGI-3 paper · ARC Prize Foundation · 24 mars 2026