
Storie DécryptageTech et IA
Que se passe-t-il vraiment quand vous posez une question à ChatGPT ?
On écrit une phrase. Quelques secondes plus tard, ChatGPT répond. Entre les deux, pourtant, notre texte a changé de nature : découpé en tokens, transformé en représentations numériques, analysé dans son contexte puis prolongé token après token. Comprendre cette mécanique permet aussi de comprendre pourquoi une IA aussi performante peut encore se tromper.
Par Florent Despréaux
À l’écran, l’expérience paraît presque banale.
Vous écrivez : « Explique-moi simplement comment fonctionne une voiture électrique. »
ChatGPT répond.
Cette apparente simplicité masque une succession d’opérations mathématiques. ChatGPT ne lit pas notre question comme nous lisons une phrase. Et il ne va pas nécessairement chercher une réponse déjà écrite quelque part. Pour comprendre ce qui se passe, il faut commencer par démonter notre texte.
1. Avant les mots, les tokens
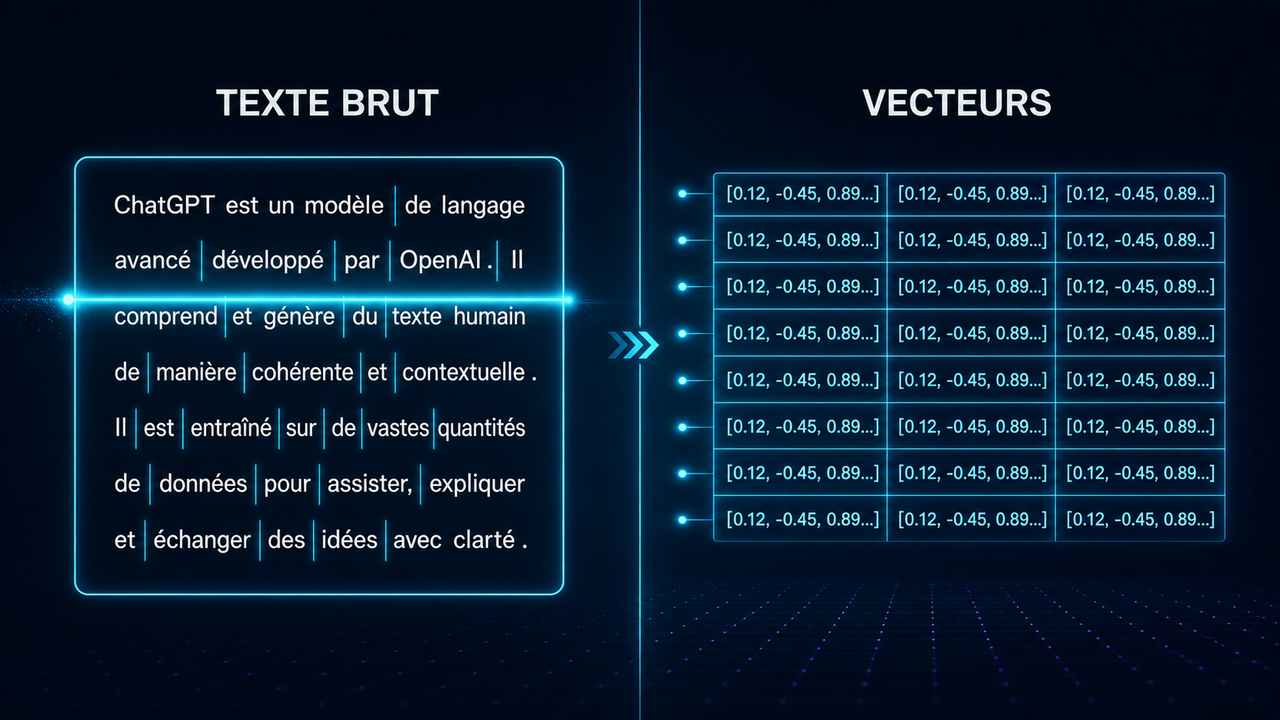
Première transformation : le texte est découpé en tokens.
Un token n'est pas forcément un mot. Il peut correspondre à un mot entier, à une partie de mot, à un signe de ponctuation ou parfois à un seul caractère. OpenAI décrit les tokens comme les unités élémentaires de texte traitées par ses modèles.
Autrement dit, la phrase que nous voyons à l'écran devient une succession d'unités manipulables par le modèle.
C’est déjà une première différence fondamentale entre notre perception du langage et celle d’un modèle : nous voyons une phrase ; la machine traite une séquence de tokens.
2. Des tokens aux nombres
Ces tokens doivent ensuite pouvoir être manipulés mathématiquement.
Ils sont associés à des représentations numériques multidimensionnelles, souvent appelées embeddings ou vecteurs dans les explications pédagogiques. L'objectif n'est pas de ranger chaque mot dans une case avec une définition fixe, mais de permettre au réseau neuronal de travailler sur des relations apprises entre les éléments du langage.
Nous quittons donc complètement le monde des phrases telles que nous les voyons. Pour le modèle, ce sont désormais des nombres. Et c’est là qu’intervient une pièce essentielle de l’architecture : le Transformer.
3. L’attention : regarder le contexte
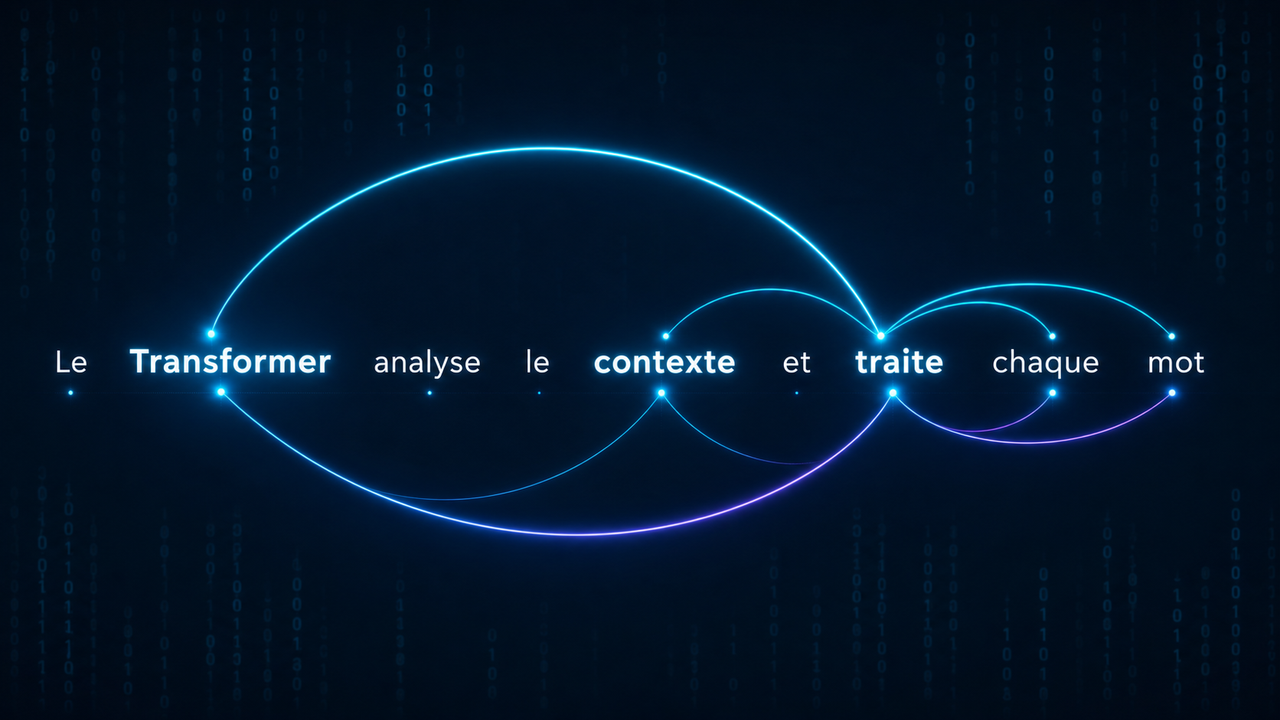
L'architecture Transformer repose notamment sur des mécanismes d’attention.
Le principe général est puissant : lorsqu'un élément d'une séquence est traité, le modèle peut pondérer les relations avec d'autres éléments du contexte. OpenAI décrit ainsi l’attention comme un processus dans lequel les pondérations entre éléments sont calculées dynamiquement selon le contexte.
Prenons : « L’avocat mange un avocat. »
Nous comprenons immédiatement que le premier « avocat » peut désigner une personne et le second un fruit. Le mot seul ne suffit donc pas : son environnement compte. Les mécanismes d’attention participent précisément à cette prise en compte des relations dans la séquence.
4. ChatGPT prédit la suite
Un modèle de langage génératif produit sa réponse séquentiellement.
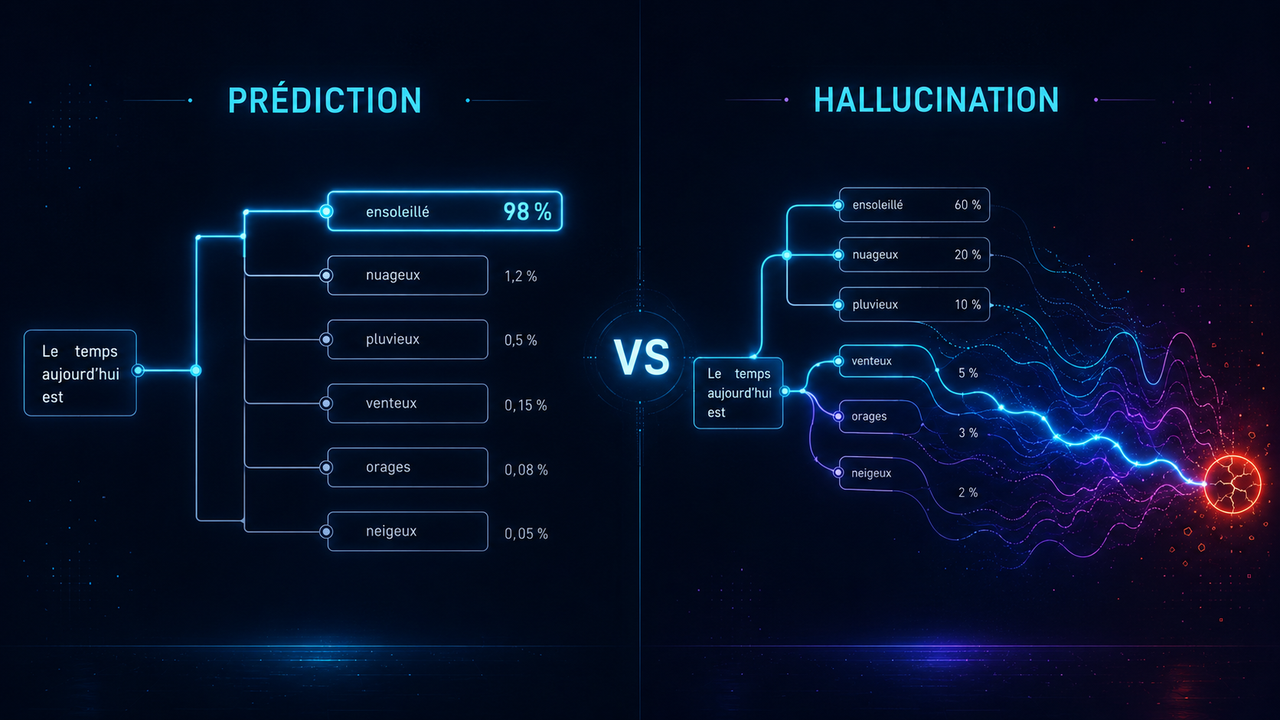
À partir du contexte disponible, il calcule une distribution de probabilités sur les tokens susceptibles de suivre. Un token est produit, puis ce nouveau token rejoint le contexte utilisé pour générer la suite. Puis un autre. Puis encore un autre.
OpenAI explique explicitement que ses systèmes prennent les tokens d'entrée, les traitent, puis génèrent la réponse sous forme d’une nouvelle séquence de tokens reconvertie en texte.
Cette prédiction répétée à très grande échelle peut produire des raisonnements, des explications, du code ou des textes remarquablement structurés. Mais elle entraîne aussi une conséquence essentielle.
5. Pourquoi ChatGPT peut halluciner
Une phrase peut être linguistiquement très plausible et factuellement fausse. C’est ce qu’on appelle communément une hallucination.
Dans une publication de septembre 2025, OpenAI définit les hallucinations comme des affirmations plausibles mais fausses générées par les modèles de langage. L’entreprise relie notamment leur origine à l’apprentissage par prédiction et explique que certaines méthodes d’évaluation peuvent encourager les modèles à deviner plutôt qu’à reconnaître leur incertitude.
C’est un point essentiel pour utiliser correctement ChatGPT : la fluidité d’une réponse n’est pas une preuve de sa véracité. Une date, un chiffre, une citation ou une source importante doivent donc être vérifiés.
6. Et la mémoire ?
Dire que « ChatGPT n’a pas de mémoire » serait aujourd’hui inexact. Il faut distinguer le contexte utilisé pour produire une réponse et les fonctions de mémoire du produit ChatGPT.
Lorsqu’elle est activée, la mémoire de ChatGPT peut exploiter du contexte utile issu des conversations et, selon les fonctionnalités disponibles, d’autres sources afin de personnaliser les réponses. Cette mémoire peut être activée ou désactivée par l’utilisateur.
Cela ne transforme pas pour autant ChatGPT en cerveau humain disposant d’une mémoire exhaustive de tout ce qu’il a vu. Le système sélectionne et exploite du contexte. La nuance est importante.
7. Mieux parler à ChatGPT
Comprendre cette mécanique change finalement notre manière de l’utiliser. Une demande vague laisse davantage d’interprétations possibles. Une demande contextualisée contraint davantage la réponse.
Au lieu d’écrire : « Fais-moi un article sur l’IA », on peut préciser : « Rédige un article pédagogique de 800 mots destiné à un public non technique. Explique les tokens, l’attention et les hallucinations avec des exemples simples. Vérifie les affirmations factuelles et indique tes sources. »
L’utilisateur apporte alors ce dont le modèle a besoin : un objectif, du contexte, des contraintes et un résultat attendu.
ChatGPT paraît parfois magique parce que toute cette mécanique disparaît derrière une simple zone de texte. Mais derrière chaque réponse se trouve une réalité beaucoup moins mystérieuse : des tokens, des représentations numériques, des mécanismes d’attention et une génération séquentielle extrêmement sophistiquée.
Et comprendre cela permet peut-être d’utiliser l’IA de la meilleure manière possible : non pas comme une machine qui sait nécessairement, mais comme un système extraordinairement puissant dont il faut aussi connaître les limites.
Sources
- Understanding and counting tokensOpenAI Help Center · OpenAI
- Why language models hallucinateOpenAI · OpenAI · 5 septembre 2025
- Memory FAQOpenAI Help Center · OpenAI
- Generative modeling with sparse transformersOpenAI · OpenAI · 23 avril 2019