
Storie DécryptageTech et IA
MMLU saturé, SWE-bench cassé, ARC transformé : les IA progressent plus vite que les tests censés les mesurer
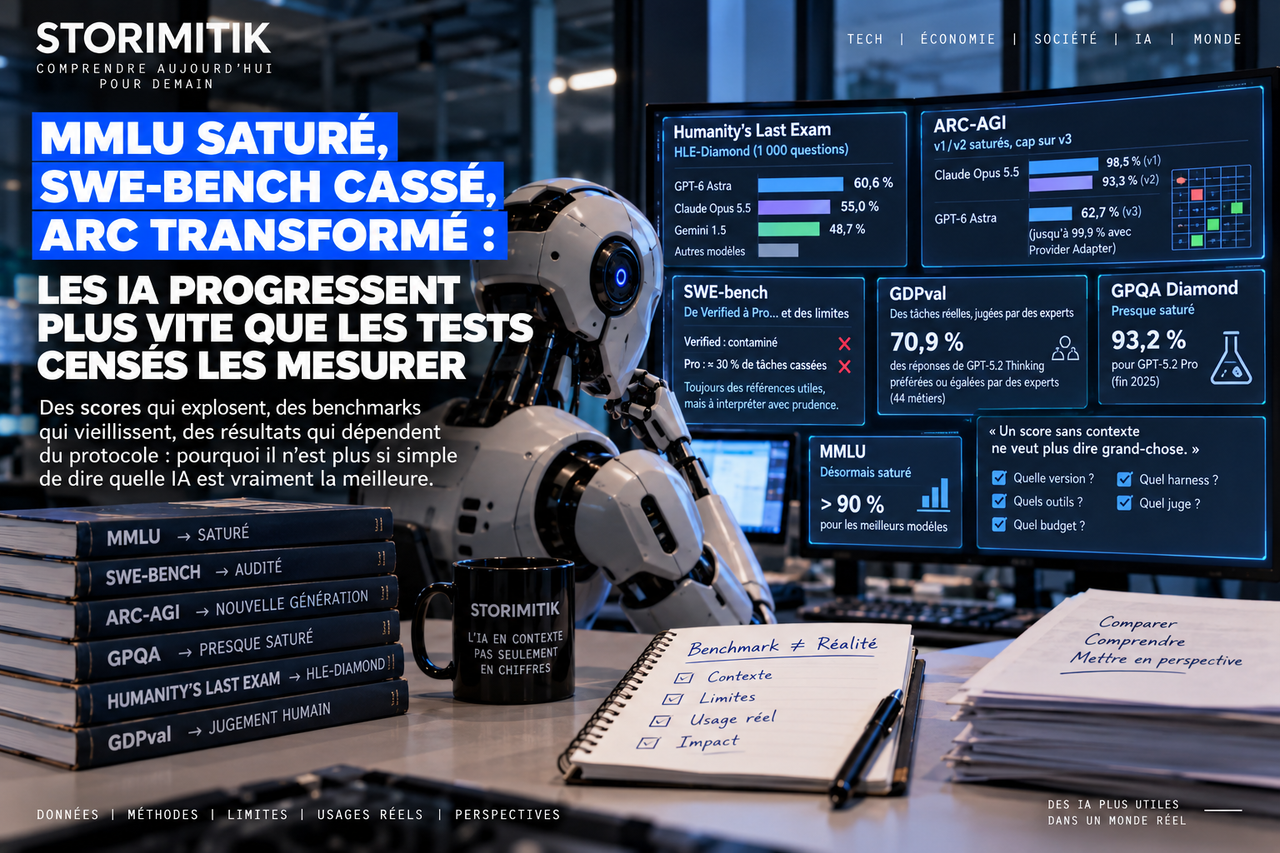
Les benchmarks qui servaient hier à départager les meilleures IA saturent, se transforment ou révèlent leurs propres défauts. MMLU dépasse 90 % chez les modèles de pointe, SWE-bench Pro comporte environ 30 % de tâches problématiques, ARC-AGI-3 peut faire varier un même modèle de 62,7 % à 99,9 % selon le harness. En 2026, lire un score exige donc de comprendre tout le protocole qui se cache derrière.
Par Florent Despréaux
Le problème n’est plus seulement de tester l’IA. C’est de construire des tests qui restent difficiles assez longtemps.
Pendant des années, les classements de modèles donnaient l’impression qu’un score suffisait à résumer l’intelligence d’une IA. En 2026, cette lecture devient de moins en moins fiable. Certains benchmarks académiques sont presque saturés, d’autres ont dû être nettoyés ou remplacés, et plusieurs évaluations produisent des résultats très différents selon les outils, le budget ou le protocole utilisé.
La question n’est donc plus seulement : « quel modèle obtient le meilleur score ? » Il faut désormais demander : sur quelle version du test, avec quels outils, quel harness, quel budget, quel juge et pour quel usage réel ?
MMLU : le benchmark qui a fini par devenir trop facile
MMLU a longtemps servi de référence pour mesurer les connaissances générales et le raisonnement sur de nombreux domaines académiques. Mais les créateurs de Humanity’s Last Exam soulignent désormais que les grands modèles dépassent 90 % sur des benchmarks populaires comme MMLU.
À ce niveau, un test peut encore détecter des erreurs, mais il devient beaucoup moins utile pour départager les meilleurs modèles. C’est l’un des paradoxes de l’évaluation de l’IA : plus les systèmes progressent, plus les examens qui les mesuraient perdent rapidement leur pouvoir discriminant.
Humanity’s Last Exam devait repousser la saturation. Il a déjà dû évoluer.
Humanity’s Last Exam a été finalisé avec 2 500 questions couvrant plus d’une centaine de domaines et conçues par près d’un millier de contributeurs experts. L’objectif était précisément de créer un examen suffisamment difficile pour les modèles de pointe.
Mais le 22 septembre 2026, le Center for AI Safety et Scale AI ont lancé HLE-Diamond : une version affinée et nettoyée de 1 000 questions, réparties à parts égales entre raisonnement et connaissances expertes. Sans outils, GPT-6 Astra y obtient 60,6 %, Claude Opus 5.5 55,0 % et Claude Fable 5.1 51,3 %. Avec web et code, les scores montent fortement : Astra atteint 82,9 %.
Ce seul écart montre déjà pourquoi un score ne peut pas être lu sans contexte : autoriser les outils change la question mesurée. On ne teste plus seulement ce que le modèle sait ou peut raisonner seul, mais aussi sa capacité à chercher et à utiliser des ressources externes.
ARC-AGI : le même modèle peut passer de 62,7 % à 99,9 % selon le harness
ARC-AGI a été conçu pour tester la généralisation sur des règles inédites plutôt que la simple restitution de connaissances. Les anciennes versions sont elles aussi devenues beaucoup plus faciles pour certains modèles : GPT-6 Astra atteint jusqu’à 98,5 % sur ARC-AGI-1 et 93,3 % sur ARC-AGI-2 selon la configuration publiée par ARC Prize.
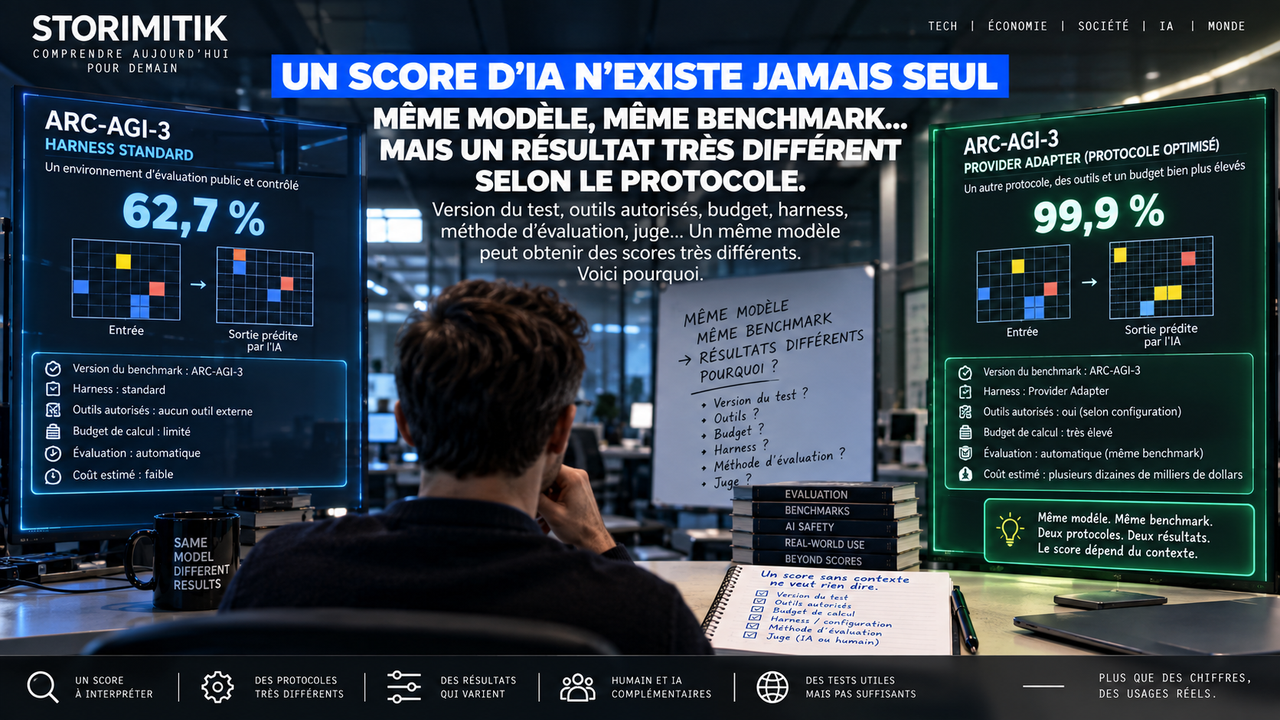
Le nouveau front est ARC-AGI-3, composé d’environnements interactifs abstraits dans lesquels le modèle doit comprendre les règles, conserver un état et agir. Là, le protocole devient déterminant : GPT-6 Astra obtient 62,7 % avec le harness standard, mais jusqu’à 99,9 % avec un Provider Adapter qui préserve davantage d’état de raisonnement entre les requêtes.
ARC Prize insiste lui-même sur le fait que ces deux configurations répondent à deux questions différentes. Le harness standard cherche une comparaison provider-neutral. Le Provider Adapter mesure ce que le modèle peut faire avec les mécanismes de contexte conçus par son fournisseur.
Autrement dit, écrire simplement « Astra = 99,9 % sur ARC-AGI-3 » serait trompeur. Le score n’existe pas sans le protocole qui le produit.
SWE-bench : le benchmark de code qui a lui-même dû être audité
Le problème est encore plus visible dans le code. SWE-bench Verified avait déjà été critiqué pour des problèmes de conception et de contamination, au point qu’OpenAI avait recommandé de passer à SWE-bench Pro.
Puis, en juillet 2026, OpenAI a publié un audit de SWE-bench Pro lui-même. Ses pipelines ont signalé 27,4 % de tâches cassées, tandis qu’une annotation humaine en a identifié 34,1 %. L’entreprise retient une estimation d’environ 30 % de tâches problématiques.
Les défauts sont très concrets : tests trop stricts, prompts incomplets, couverture insuffisante ou instructions qui orientent le modèle vers un comportement que les tests cachés refusent ensuite. Une IA peut donc produire une correction fonctionnelle et être déclarée en échec — ou inversement passer avec une solution incomplète.
GPQA Diamond : même les examens scientifiques de pointe approchent leurs limites
GPQA Diamond mesure des questions de physique, chimie et biologie de niveau universitaire avancé, conçues pour être difficiles à résoudre par simple recherche. Pourtant, GPT-5.2 Pro atteignait déjà 93,2 % sans outils fin 2025.
Cela ne signifie pas que la science est « résolue ». Le benchmark teste un type précis de question fermée. Il ne mesure ni la capacité à conduire une recherche autonome, ni la qualité d’une expérimentation, ni la robustesse d’un raisonnement sur plusieurs jours.
GDPval change la question : l’IA produit-elle réellement un bon travail ?
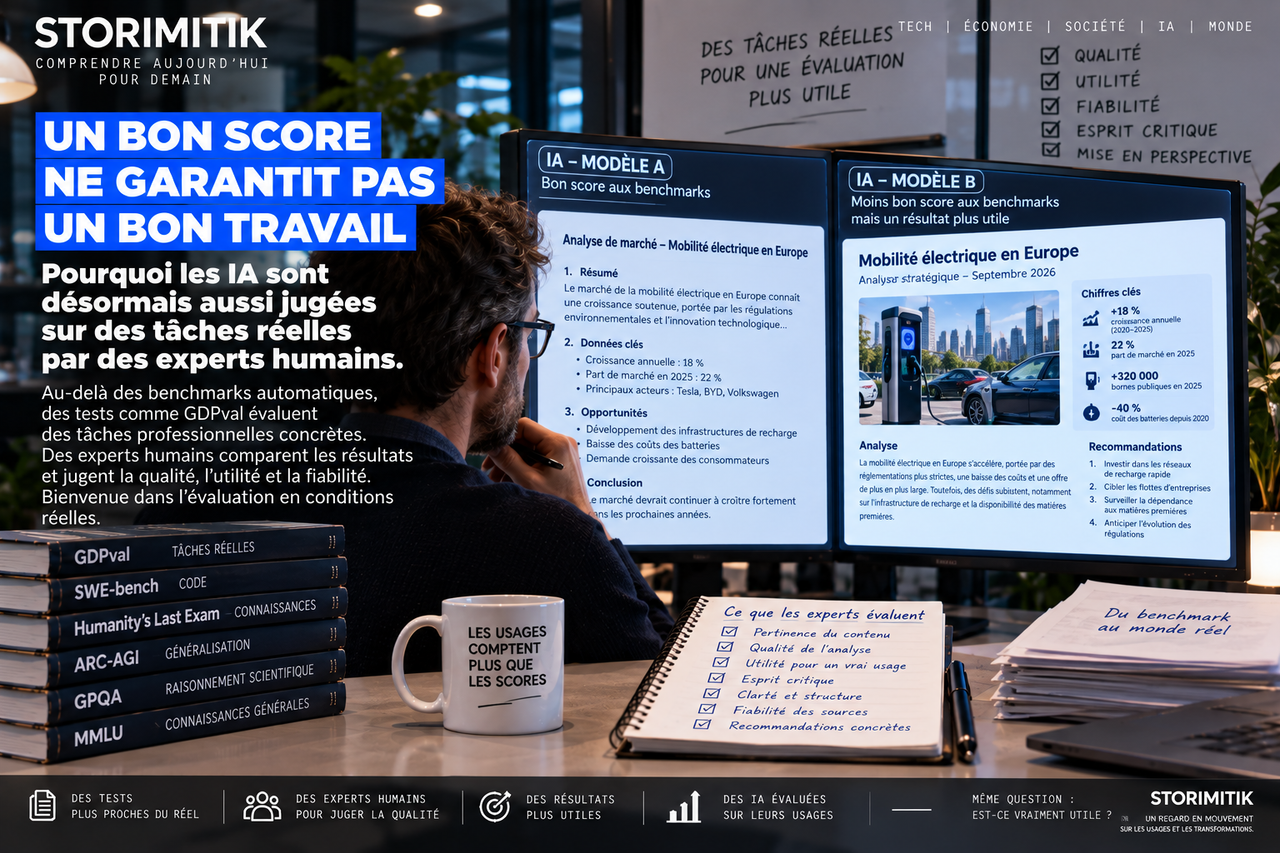
GDPval part d’une logique différente. Plutôt que de demander uniquement une bonne réponse à une question, il évalue des livrables professionnels sur des tâches couvrant 44 métiers dans neuf grands secteurs de l’économie américaine : présentations commerciales, feuilles de calcul, plannings, diagrammes, documents ou vidéos.
Le standard de notation de GDPval repose sur une comparaison paire par des experts humains. Les évaluateurs jugent la qualité de la production du modèle face à celle d’un professionnel.
Sur ce protocole, GPT-5.2 Thinking battait ou égalait les meilleurs professionnels dans 70,9 % des comparaisons publiées fin 2025. Mais ce chiffre mesure une préférence humaine sur des tâches bien spécifiées ; ce n’est pas un taux de réussite universel du travail de bureau.
Automatique ou humain ? L’évaluation moderne mélange désormais les deux
Les benchmarks automatiques restent indispensables : ils sont rapides, reproductibles et permettent de comparer beaucoup de systèmes. Mais les tâches réelles deviennent trop ouvertes pour être réduites à une seule réponse exacte.
Le jugement humain apporte alors ce que le score automatique mesure mal : pertinence, clarté, qualité du raisonnement, respect du contexte, valeur du livrable et utilité réelle. En contrepartie, il coûte plus cher, prend plus de temps et introduit lui aussi de la variabilité.
Le benchmark n’est pas faux. Il répond simplement à une question plus étroite qu’on ne le croit.
Un score reste utile si l’on sait précisément ce qu’il mesure. HLE-Diamond teste des connaissances et du raisonnement expert. ARC-AGI étudie la généralisation et l’action dans des environnements nouveaux. SWE-bench vise l’ingénierie logicielle. GPQA sonde le raisonnement scientifique. GDPval rapproche l’évaluation du travail professionnel.
Le piège commence lorsque ces résultats deviennent un classement global de « l’intelligence » ou de « la meilleure IA » sans rappeler les conditions de test.
En 2026, le protocole devient presque aussi important que le modèle
Les modèles progressent désormais assez vite pour que leurs examens deviennent eux-mêmes des objets de recherche. Il faut nettoyer les jeux de données, changer les tâches, limiter la contamination, documenter les outils, mesurer les coûts et parfois introduire des humains dans la boucle.
C’est peut-être la leçon la plus importante de cette nouvelle génération de benchmarks : le chiffre final reste nécessaire, mais il n’est plus suffisant. Pour savoir ce qu’une IA vaut réellement, il faut comprendre comment elle a été testée — puis vérifier ce qu’elle sait faire hors du laboratoire.
Sources
- Introducing HLE-DiamondHumanity’s Last Exam — CAIS / Scale AI · Center for AI Safety et Scale AI · 22 septembre 2026
- Humanity’s Last ExamHumanity’s Last Exam — CAIS / Scale AI · Center for AI Safety et Scale AI
- OpenAI’s GPT-6 Astra on ARC-AGI-3ARC Prize · Greg Kamradt · 3 septembre 2026
- Separating signal from noise in coding evaluationsOpenAI · OpenAI · 8 juillet 2026
- Introducing GPT-5.2OpenAI · OpenAI · 11 décembre 2025
- GDPval — Real-world, economically valuable knowledge work tasksOpenAI Evals · OpenAI
- Advancing science and math with GPT-5.2OpenAI · OpenAI